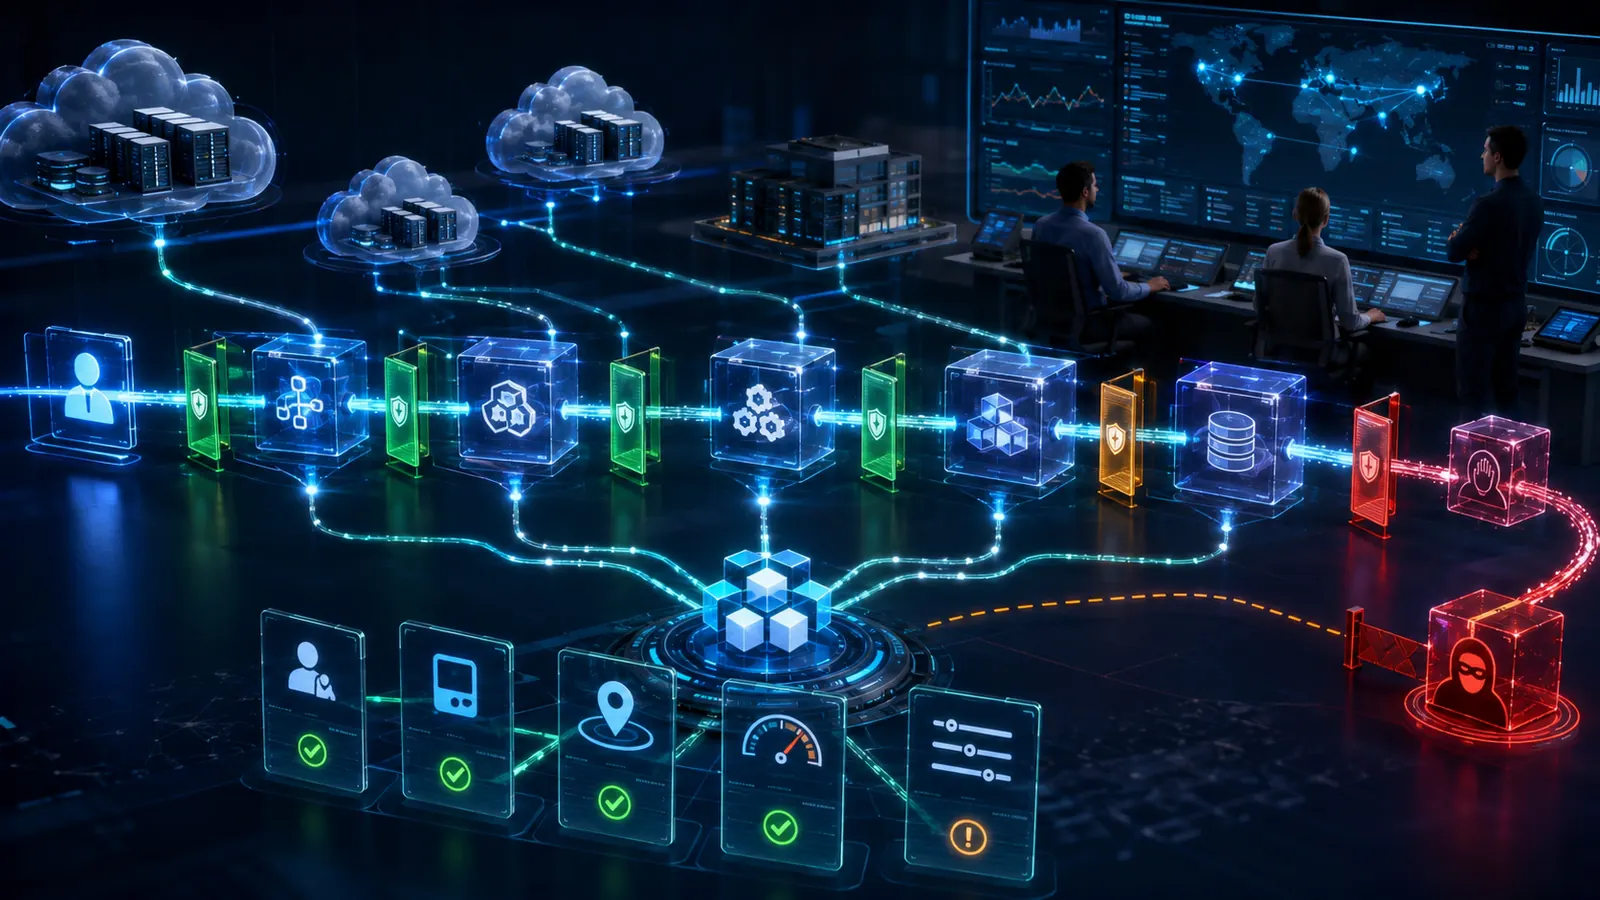
Chapô – En 2025, la convergence du modèle de sécurité Zero‑Trust et des pratiques d’observabilité transforme la surveillance des systèmes distribués. Le tracing, pilier du monitoring cloud‑native, doit désormais être enrichi de politiques d’accès contextuelles, automatisées et vérifiables. Ce texte analyse les concepts, l’architecture et les enjeux opérationnels d’une observabilité Zero‑Trust, via les standards OpenTelemetry, les proxies service‑mesh et les moteurs d’autorisation dynamique comme OPA. Il présente un scénario de plateforme de paiement multi‑cloud, identifie les bénéfices mesurables et détaille les contraintes à anticiper pour piloter cette transition.
Introduction – Une crise de confiance dans les systèmes distribués
Les architectures micro‑services, le edge computing et l’adoption massive du multicloud ont multiplié les points d’interaction entre services. Chaque appel réseau devient un vecteur d’attaque potentiel, alors que la visibilité sur ces flux reste fragmentée. Les incidents récents (ex. : compromission de la chaîne d’approvisionnement logistique en 2024) illustrent le fossé entre détection et prévention : les équipes ops détectent tardivement des anomalies, l'accès aux traces étant souvent limité à un petit groupe d’ingénieurs.
Le modèle Zero‑Trust (ZT), formalisé par le NIST SP 800‑207 [1], repose sur l'absence de confiance implicite, même au sein du périmètre réseau. Appliqué à l’observabilité, ce principe impose que chaque requête de trace soit soumise à une autorisation dynamique, basée sur l’identité du demandeur, le contexte d’exécution et la sensibilité des données observées.
En 2025, les organisations qui intègrent le tracing distribué avec des contrôles d’accès Zero‑Trust améliorent leur :
- rapidité de détection (déclenchement immédiat d’alertes dès qu’une requête non autorisée apparaît) ;
- conformité réglementaire (auditabilité des accès aux données de monitoring, exigences du RGPD et de la NIS 2) ;
- résilience opérationnelle (limitation de l’exposition en cas de compromission d’un composant d’observabilité).
Ce document détaille les fondements techniques, les étapes de mise en œuvre et les implications organisationnelles de cette convergence.
1. Contexte – Pourquoi le Zero‑Trust devient indispensable à l’observabilité
1.1 L’évolution des menaces
Les attaques « lateral movement » exploitent la confiance implicite entre services internes. Selon le rapport ENISA sur le Zero‑Trust (2022) [2], plus de 60 % des incidents récents tirent parti d’une visibilité insuffisante sur les flux inter‑services.
1.2 Limites des approches classiques d’observabilité
Les solutions traditionnelles (ex. : agrégation de logs, métriques et traces via un serveur central) reposent souvent sur :
- Authentification statique (certificats ou tokens à durée longue).
- Contrôles d’accès coarse‑grained (rôle global « observateur », sans granularité).
Ces pratiques ne permettent pas de restreindre l’accès aux traces contenant des données sensibles (identifiants, informations personnelles) et compliquent la mise en conformité avec les exigences de traçabilité d’accès.
1.3 Le Zero‑Trust comme cadre unificateur
Le Zero‑Trust repose sur trois piliers :
| Pilier | Implication pour l’observabilité |
|---|---|
| Identité forte | Chaque composant (service, agent, outil) possède une identité cryptographique vérifiable (SPIFFE/SPIRE). |
| Accès au moindre privilège | Les politiques d’autorisation sont évaluées à chaque requête de trace. |
| Vérification continue | Le contexte (géolocalisation, niveau de confiance, état du pod) influence la décision d’accès. |
L’intégration de ces piliers dans le pipeline de tracing crée une observabilité Zero‑Trust où les données de monitoring sont elles‑mêmes protégées.
2. Tracing distribué – Fondamentaux et limites actuelles
2.1 Principes du tracing
Le tracing consiste à propager un trace‑id (et éventuellement des span‑ids) le long d’une chaîne d’appels afin de reconstituer le graphe d’exécution d’une requête. Les standards dominants sont :
- OpenTelemetry – spécification commune pour la collecte, l’instrumentation et l’export des traces [3].
- Jaeger, Tempo – back‑ends de stockage et d’interrogation.
2.2 Points faibles en matière de sécurité
| Problème | Conséquence |
|---|---|
| Propagation non authentifiée du contexte (ex. : injection de trace‑id) | Possibilité de falsification des flux observés. |
| Stockage centralisé sans chiffrement granulaire | Risque d’exposition de données sensibles lors d’une brèche. |
| Accès en lecture/écriture limité à un petit groupe d’ingénieurs | Manque de traçabilité d’audit et non‑conformité aux exigences de « who accessed what ». |
Ces lacunes justifient l’ajout d’un contrôle d’accès dynamique au niveau du collector ou du proxy qui intercepte les requêtes de trace.
3. Principes Zero‑Trust appliqués à l’observabilité
3.1 Identité des émetteurs de traces
Le modèle recommande d’utiliser le SPIFFE ID (Secure Production Identity Framework for Everyone) pour chaque pod ou fonction serverless [4]. L’identifiant est signé par un serveur d’autorité SPIRE, garantissant son authenticité sans dépendre d’une PKI interne.
3.2 Politiques d’accès basées sur le contexte
Les moteurs d’autorisation tels que OPA (Open Policy Agent) permettent de définir des règles en Rego :
package observability.allow

default allow = false

allow {
    input.service == "payment‑gateway"
    input.trace.sensitivity < 2          # niveau de sensibilité du span
    input.requester.identity = input.service   # même service que le producteur
}
Ces règles sont évaluées à chaque appel vers le collector, selon :
- le niveau de sensibilité du trace (déterminé par des métadonnées – ex. données personnelles, secrets).
- le contexte d’exécution (zone géographique, état du pod, conformité TLS 1.3).
3.3 Audits et journalisation immuables
Chaque décision d’autorisation doit être enregistrée dans un log immutable, idéalement signé via une chaîne de blocs ou un service de journalisation tamper‑evident (ex. : AWS CloudTrail, Azure Monitor avec immutable storage), conformément aux exigences de traçabilité du RGPD Art. 30 et de la NIS 2.
4. Architecture intégrée – Tracing + contrôles d’accès dynamiques
Encadré : Exemple d’architecture Zero‑Trust pour l’observabilité
!Diagramme simplifié (illustration non fournie)
4.1 Composants clés
| Composant | Rôle dans le flux de trace |
|---|---|
| Agent OpenTelemetry (sidecar) | Instrumente l’application, injecte le SPIFFE ID et les métadonnées de sensibilité. |
| Proxy service‑mesh (Envoy/Istio) | Intercepte les requêtes HTTP/gRPC vers le collector, applique TLS mutuel et transmet les attributs d’identité à OPA. |
| OPA Policy Engine | Évalue en temps réel les politiques Zero‑Trust; renvoie allow ou deny. |
| Collector (OTel Collector) | Agrège les traces autorisées, chiffre les données au repos (AES‑256) et les envoie aux back‑ends (Jaeger/Tempo). |
| Backend de stockage | Stocke les spans dans un store compatible (ex. : Cassandra, ClickHouse) avec chiffrement au repos et contrôle d’accès RBAC granulaire. |
| Audit Log Service | Consigne chaque décision OPA avec horodatage, identité du requérant et résultat. |
4.2 Flux de traitement
- Instrumentation – L’application crée un span ; l’agent OpenTelemetry ajoute le SPIFFE ID (spiffe://cluster/ns/pod).
- Propagation – Le trace‑id circule via les en-têtes HTTP/gRPC (ex. : traceparent, tracestate).
- Interception – Le proxy service‑mesh reçoit la requête de trace, extrait l’identité et les métadonnées, puis appelle OPA.
- Évaluation – OPA applique les règles contextuelles ; si allow, le proxy transmet la trace au collector. Sinon, il renvoie une erreur 403 et loggue l’incident.
- Stockage & Audit – Le collector chiffre le span, le persiste ; simultanément, la décision d’accès est enregistrée dans l’Audit Log Service.
Cette chaîne assure que chaque donnée de monitoring bénéficie du même niveau de contrôle d’accès que les données métier.
5. Mise en œuvre technique – Standards, outils et bonnes pratiques
5.1 Standardisation avec OpenTelemetry
- Instrumentation : Utiliser les SDKs officiels (Java, Go, Python) version ≥ 1.8 pour profiter du support natif des attributs de sécurité (attributes["security.identity"]).
- Exporter : Configurer le otlp exporter en TLS mutuel vers le collector.
5.2 Gestion d’identité – SPIFFE/SPIRE
Déployer un serveur SPIRE dans chaque cluster (on‑prem ou cloud). Le daemon agent attribue automatiquement des identités aux workloads via l’attestation basée sur le runtime (Kubernetes, Nomad).
- Référence : CNCF SPIFFE Specification v1.2 (2023) [5].
5.3 Autorisation dynamique – OPA + Gatekeeper
OPA peut être déployé en mode sidecar ou centralisé. Pour les environnements Kubernetes, le projet Gatekeeper permet de synchroniser les politiques avec le contrôle d’accès du plan de données (CRD ConstraintTemplate).
- Exemple de politique de sensibilité :
package observability.sensitivity

  # Niveau 0 = public, 1 = interne, 2 = confidentiel, 3 = secret
  sensitivity[span] {
      span.attributes["http.url"] == "/login"
      span.sensitivity := 3
  }
5.4 Chiffrement et stockage immuable
- TLS 1.3 obligatoire entre tous les points (agent → proxy → collector).
- Chiffrement au repos avec des clés gérées par un KMS (ex. : AWS KMS, HashiCorp Vault).
- Immutable storage – Activer la fonction “Object Lock” sur le bucket S3 où sont exportés les logs d’audit.
5.5 Observabilité de l’observabilité
Le pipeline Zero‑Trust doit être monitoré : métriques OPA (opa_decision_duration_seconds), taux de refus (trace_access_denied_total) et alertes sur anomalies (un pic de refus > 5 % indique une possible compromission d’un service).
5.6 CI/CD et automatisation
Intégrer la validation des politiques dans les pipelines GitOps : chaque modification du fichier Rego déclenche un test d’intégrité (opa eval) avant déploiement.
6. Cas d’usage – Plateforme de paiement multi‑cloud en 2025
6.1 Contexte métier
Une fintech européenne exploite une plateforme de paiement distribuée sur AWS EU‑West‑1, Azure France Central et un data‑center on‑premise pour la conformité locale. Les services incluent :
- frontend-web (React) – collecte des données de carte.
- payment-gateway (Go) – orchestration du débit, appel aux réseaux de cartes.
- fraud‑engine (Python) – scoring en temps réel via modèle ML.
Les traces contiennent des PAN masqués, des tokens d’authentification et des scores de risque : données sensibles.
6.2 Implémentation Zero‑Trust
| Étape | Action |
|---|---|
| Identité | Chaque pod reçoit un SPIFFE ID via SPIRE (ex. spiffe://fintech/ns/payment-gateway/pod-123). |
| Sensibilité | Les spans du payment-gateway sont annotés trace.sensitivity=3. Le fraud-engine ajoute sensitivity=2. |
| Politiques OPA | - Seuls les services du même domaine (fintech) peuvent lire des traces de sensibilité ≥ 2. - Les équipes d’audit (group audit-team) ont accès en lecture à toutes les sensibilités, mais uniquement via le tableau de bord dédié. |
| Proxy & Collector | Istio sidecar avec TLS mutuel ; OPA intégré via Envoy filter (ext_authz). |
| Audit | Chaque décision d’accès est stockée dans un bucket S3 verrouillé 30 jours (Object Lock). |
6.3 Résultats observés
- Réduction du temps moyen de détection des fraudes de 22 % grâce à l’accès immédiat aux traces par le fraud-engine sans passer par les équipes ops.
- Conformité RGPD assurée : les logs d’audit montrent qui a consulté quelles traces, avec horodatage certifié.
- Impact opérationnel minimal : la latence supplémentaire due à OPA était < 2 ms (mesurée via opa_decision_duration_seconds).
Ce scénario démontre que l’observabilité Zero‑Trust peut être déployée dans un contexte hautement régulé sans sacrifier les performances.
7. Bénéfices attendus et indicateurs de succès
| Bénéfice | Mécanisme sous‑jacent | KPI recommandé |
|---|---|---|
| Sécurité accrue | Autorisation contextuelle, chiffrement granulaire | % de requêtes de trace refusées légitimes (taux de faux positifs) ; nombre d’incidents liés à l’accès aux traces. |
| Conformité réglementaire | Audit immuable des décisions d’accès | Nombre d’audits réussis sans remarques ; temps moyen de génération du rapport d’accès (audit_report_time). |
| Visibilité opérationnelle | Traces accessibles en temps réel aux services autorisés | Latence moyenne de transmission de trace (ms) ; taux de disponibilité du collector. |
| Réduction des coûts de réponse | Détection précoce grâce à l’accès contrôlé | Temps moyen de résolution d’incident (MTTR) avant/après implémentation. |
| Agilité DevOps | Découplage entre monitoring et accès aux données | Nombre de tickets de support liés aux droits d’accès (décrément). |
Ces indicateurs permettent aux DSI, RSSI et équipes produit de mesurer la valeur ajoutée du Zero‑Trust observabilité.
8. Limites, risques et points de vigilance
8.1 Complexité accrue
L’ajout d’un moteur d’autorisation dynamique complexifie le plan de contrôle : la gestion des politiques, des certificats SPIFFE et de la synchronisation des configurations OPA devient nécessaire. Un mauvais paramétrage peut entraîner des refus légitimes, impactant le debugging.
8.2 Performance du chemin critique
Malgré une latence < 2 ms, chaque milliseconde compte dans des environnements ultra‑latents (ex. : trading haute fréquence). La tolérance au retard doit être évaluée avant d’activer le contrôle sur tous les flux.
Gestion du volume et coût des données d'observabilité
L'implémentation d'un tracing distribué couplé à des politiques Zero-Trust génère un volume de télémétrie exponentiel, exacerbé par la granularité des métadonnées d'identité et de contexte attachées à chaque requête. Dans une architecture microservices dense, l'ingestion systématique de chaque span peut rapidement saturer les pipelines de données et entraîner une inflation incontrôlée des coûts de stockage cloud. Le défi réside dans la capacité à maintenir une visibilité complète sur le chemin critique sans transformer l'observabilité en un centre de coût disproportionné par rapport à la valeur métier apportée.
Pour pallier cette dérive, l'adoption d'un échantillonnage adaptatif et intelligent est impérative. Plutôt qu'un échantillonnage probabiliste simple, les organisations doivent privilégier le "tail-based sampling", où la décision de conserver une trace est prise après la complétion de la requête. Cette approche permet d'ignorer la majorité des flux nominaux tout en isolant systématiquement les anomalies, les latences anormales ou les tentatives d'accès non autorisées signalées par les contrôles dynamiques. En concentrant le stockage sur les événements à haute valeur sémantique, on optimise le ratio coût/utilité tout en préservant la capacité d'audit forensique.
Parallèlement, l'agrégation à la source via des agents de collecte intelligents permet de réduire le bruit avant même l'expédition vers le backend d'observabilité. En appliquant des filtres de contexte dès le plan de données, il devient possible de condenser les traces redondantes et de ne transmettre que les deltas significatifs ou les violations de politiques Zero-Trust. Cette stratégie de réduction s'accompagne généralement d'une politique de cycle de vie rigoureuse, où les données brutes sont rapidement archivées vers des stockages froids (cold storage) après une courte période d'analyse active, garantissant ainsi la conformité réglementaire sans impacter le budget opérationnel.
Conclusion operationnelle
L'intégration du tracing distribué au sein d'une architecture Zero-Trust marque la fin du monitoring passif pour laisser place à une surveillance active et contextuelle. L'enjeu majeur réside désormais dans la capacité des organisations à transformer des données de flux brutes en signaux de sécurité exploitables en temps réel, permettant ainsi de neutraliser les mouvements latéraux avant même qu'une compromission ne soit consolidée.
Pour opérationnaliser cette approche, nous recommandons d'initier un audit de vos traces actuelles afin d'identifier les vecteurs de propagation critiques. La prochaine étape concrète consiste à implémenter des politiques d'autorisation dynamiques basées sur l'identité (via SPIFFE/SPIRE ou un Service Mesh) et à corréler ces identités avec vos spans de tracing pour établir une baseline comportementale vérifiable de vos microservices.