Ce que vos données se rappellent, et comment le prouver.
Analyses, récits et retours d'ingénierie sur la Memory & Evidence Layer : mémoire d'entreprise, gouvernance de l'IA, conformité, résilience ransomware et stockage objet S3 agnostique.
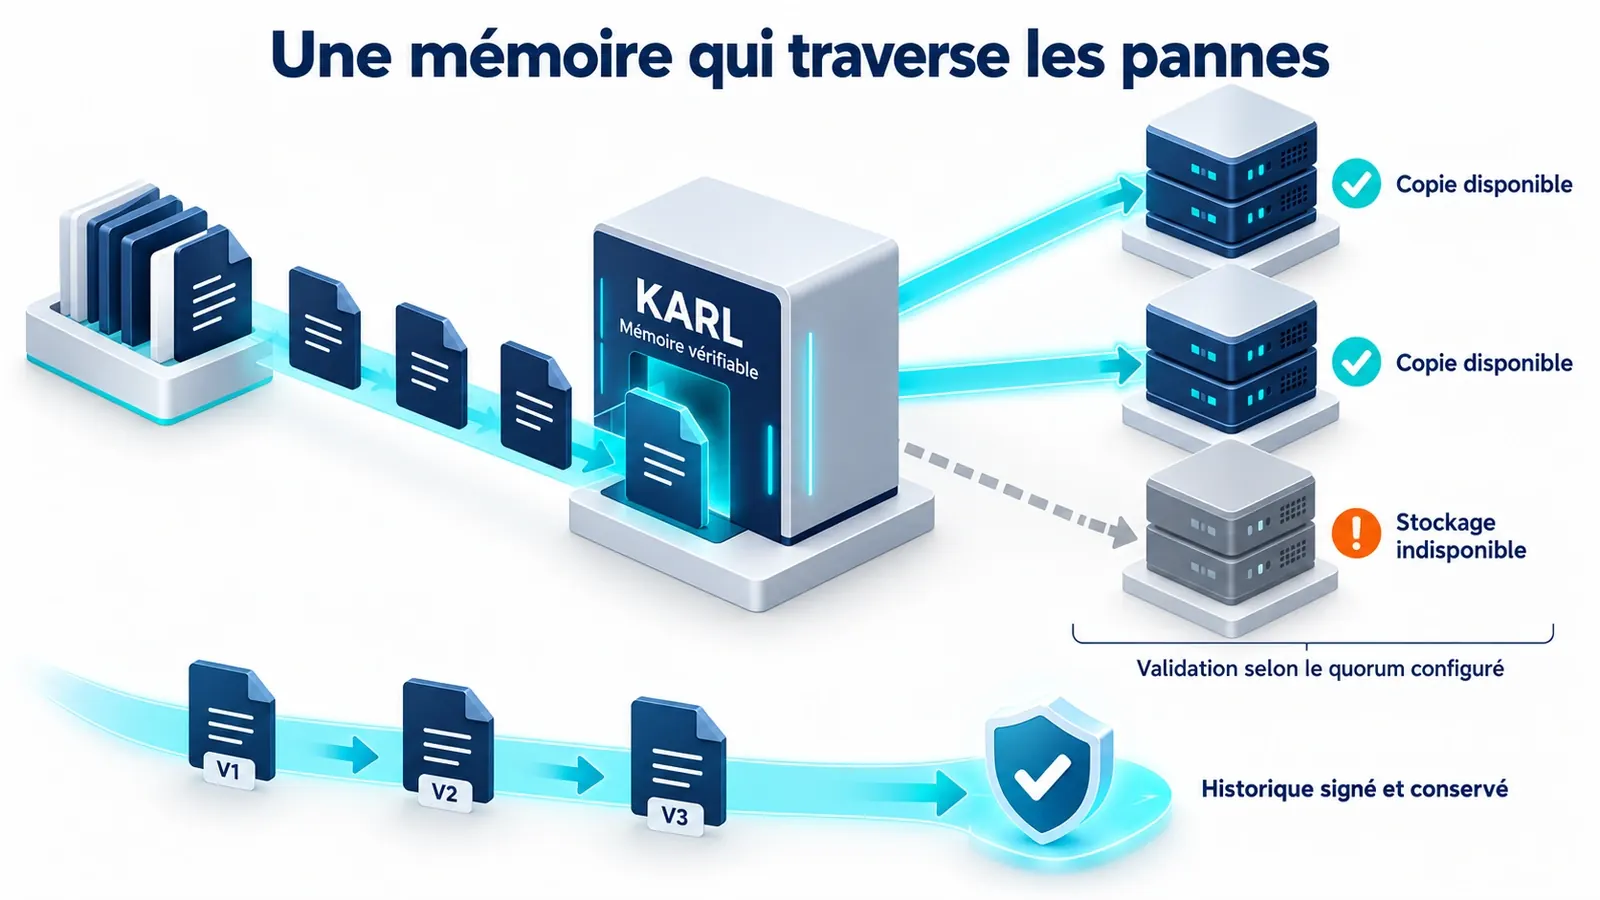
Une mémoire d'entreprise doit aussi tenir quand un serveur tombe
Un document évolue, une autorisation expire, une décision est révisée. Quelques mois plus tard, il faut retrouver les informations sur lesquelles une équipe s'était appuyée. La Memory Layer de KARL conserve les versions, leurs liens et les traces des opérations. Mais cette mémoire doit aussi traverser les incidents.
Lire l'article →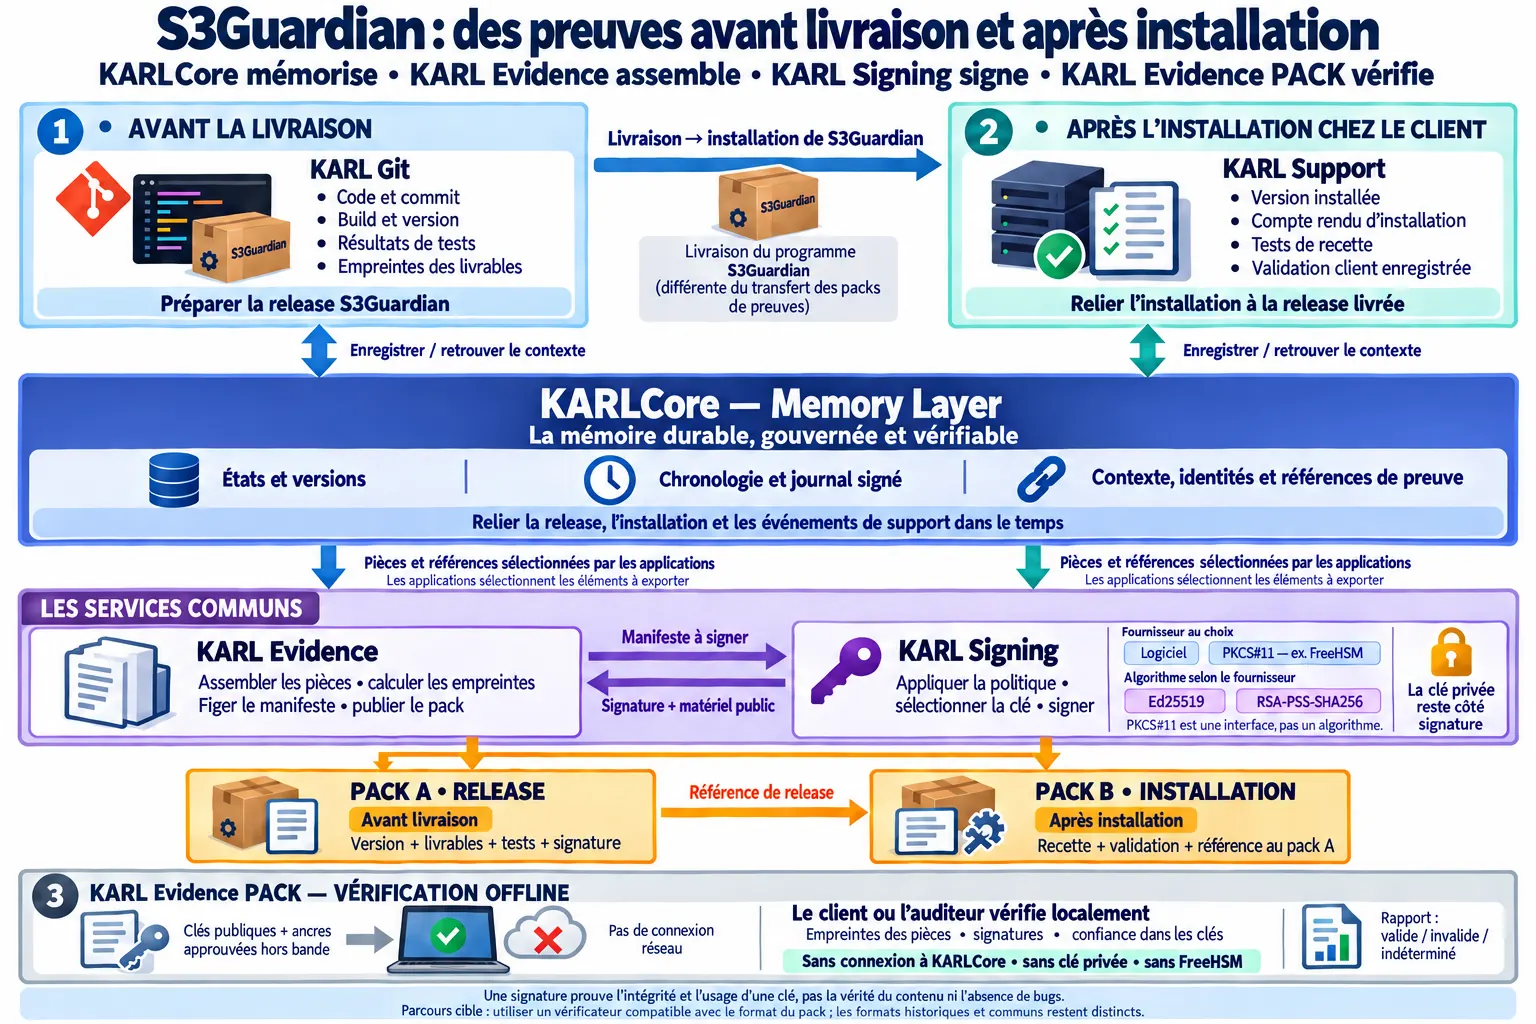
Du premier bug à la vérification chez le client : l’histoire d’une livraison S3Guardian
Comment une correction de S3Guardian devient une livraison que le client peut vérifier : du dossier de support au pack signé, jusqu'à la recette sur site.
Lire l'article →
Quand l’historique devient une mémoire utile : KARL Core au service des équipes
Comment la memory layer de KARL Core relie versions, validations et décisions pour aider les équipes à comprendre une régression et à retrouver le contexte d'un changement.
Lire l'article →Une mémoire d'entreprise doit aussi tenir quand un serveur tombe
Un document évolue, une autorisation expire, une décision est révisée. Quelques mois plus tard, il faut retrouver les informations sur lesquelles une équipe s'était appuyée. La Memory Layer de KARL conserve les versions, leurs liens et les traces des opérations. Mais cette mémoire doit aussi traverser les incidents.
Lire l'article →Du premier bug à la vérification chez le client : l’histoire d’une livraison S3Guardian
Comment une correction de S3Guardian devient une livraison que le client peut vérifier : du dossier de support au pack signé, jusqu'à la recette sur site.
Lire l'article →Quand l’historique devient une mémoire utile : KARL Core au service des équipes
Comment la memory layer de KARL Core relie versions, validations et décisions pour aider les équipes à comprendre une régression et à retrouver le contexte d'un changement.
Lire l'article →
Dix-huit mois plus tard, chaque octet était encore à sa place
Comment une équipe d'investigation a transformé une clé USB en dossier vérifiable, et pourquoi son avocate a pu le prouver, seule, sans réseau, dix-huit mois plus tard.
Lire l'article →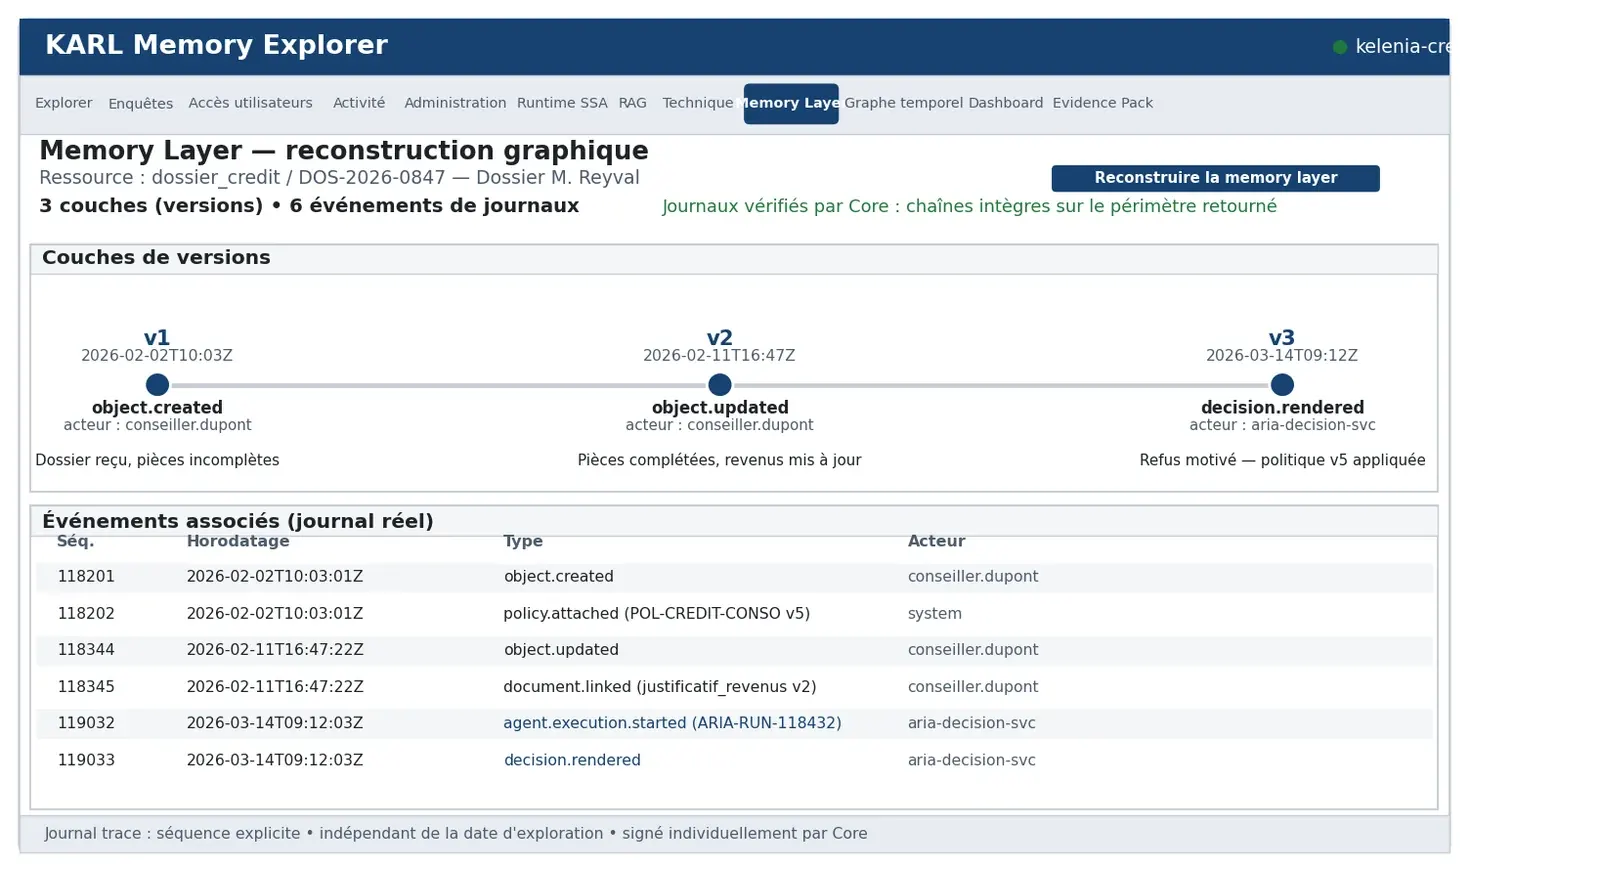
Ce que retient la presse tech de la première sortie publique de KARL
Un journaliste australien assiste à la présentation de KARL à Ljubljana et en tire un compte rendu sans complaisance : architecture sans base de données, restauration en 3 secondes, et une tarification encore à écrire.
Lire l'article →La preuve qui se vérifie sans vous : la vérification hors ligne de KARL Core
Un client conteste un refus de prêt huit mois après la décision. Répondre suppose de produire une preuve que le médiateur peut vérifier lui-même, sans avoir à croire l'organisation qui la produit.
Lire l'article →
Que savait-on, à quel moment, et pourquoi a-t-on décidé ainsi ?
Huit mois après avoir prolongé l'accès d'un fournisseur, un audit interne pose une question simple. Y répondre suppose de retrouver non pas l'état d'aujourd'hui, mais celui qui existait au moment de la décision.
Lire l'article →
Le jour où changer de fournisseur cloud est redevenu possible
Une entreprise croit avoir sécurisé son avenir avec des sauvegardes régulières. Le jour où elle doit vraiment changer de fournisseur, elle découvre que la sauvegarde ne suffit pas : c'est la mémoire de ses données qui doit pouvoir voyager.
Lire l'article →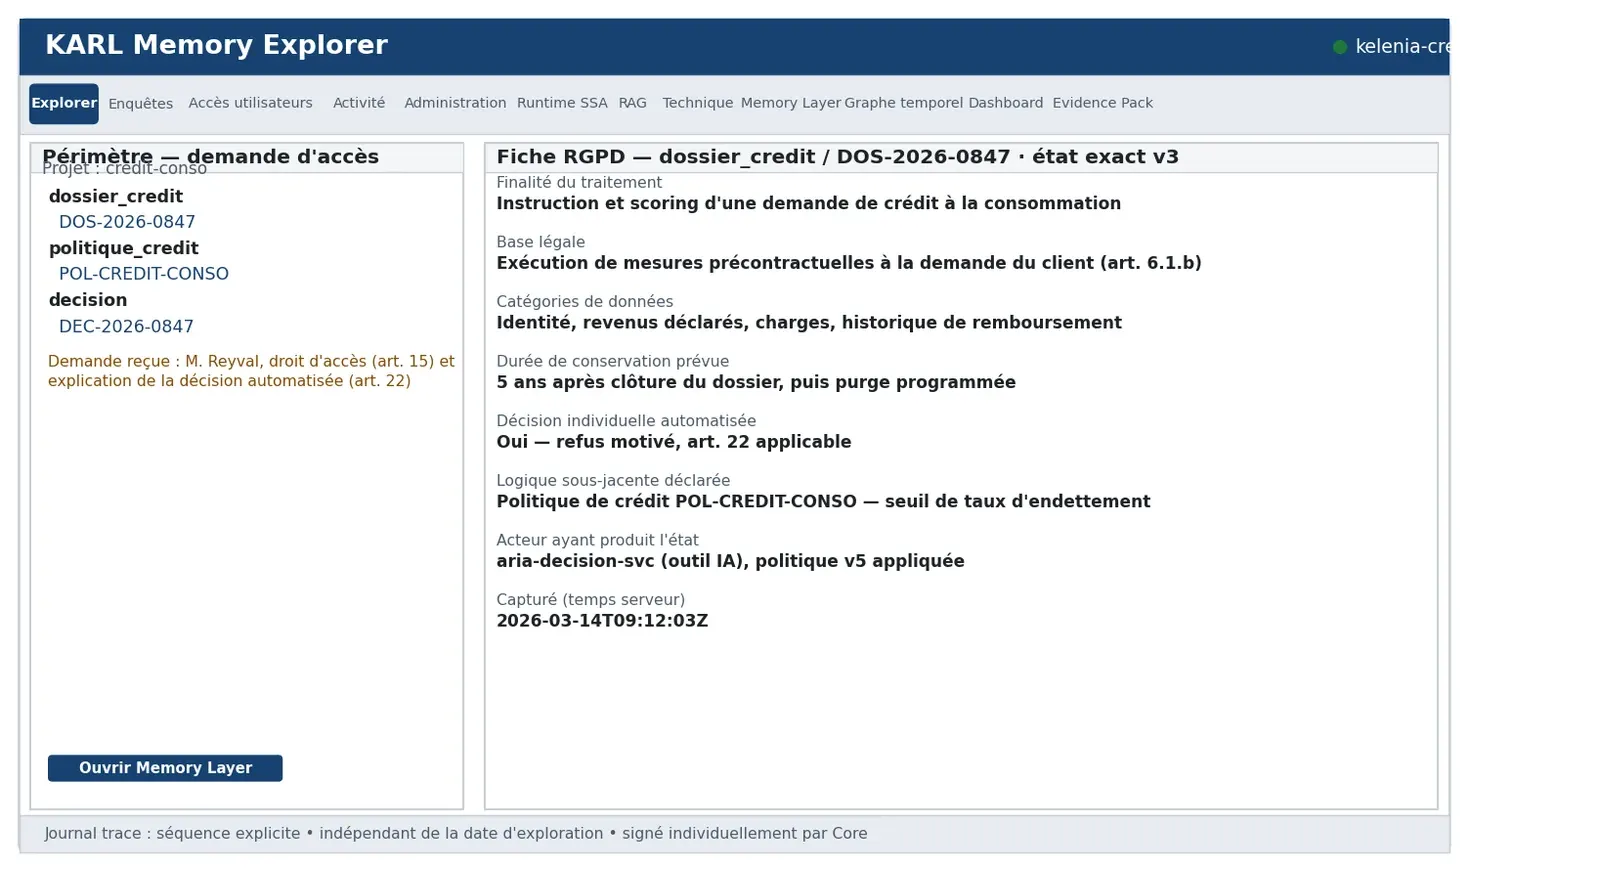
Répondre aux droits des personnes sans jamais improviser
Droit d'accès, explication d'une décision automatisée et droit à l'effacement : un scénario centré sur les obligations RGPD, illustré écran par écran depuis l'interface KARL MX.
Lire l'article →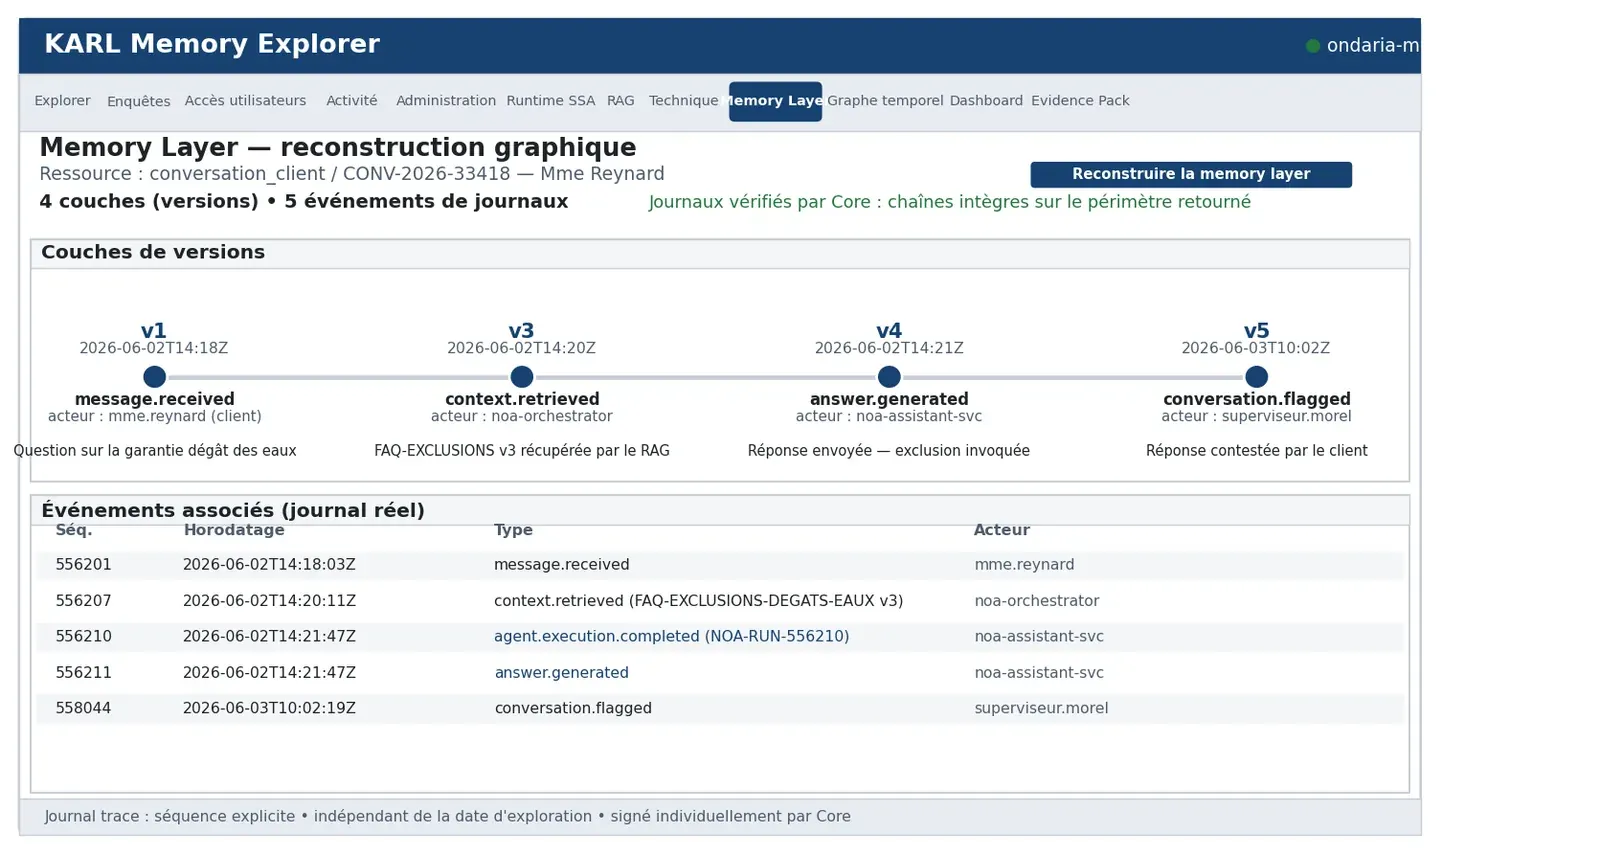
Transparence d'un agent IA : ce que NOA avait réellement lu
Versionnement des états, graphe temporel des objets et RAG gouverné : un scénario centré sur la transparence de l'IA, illustré écran par écran depuis l'interface KARL MX.
Lire l'article →Savoir ce qu'un agent avait en mémoire le jour où il a décidé
Versionnement des états, graphe temporel des objets, RAG gouverné et Evidence Pack scellé : un scénario d'entreprise complet, illustré écran par écran depuis l'interface KARL MX.
Lire l'article →
Le stockage objet a réglé l'échelle. Reste la question de la continuité.
Le stockage objet a réglé l'échelle : capacité en service, rétention en paramètre, accès par API. Il n'a jamais promis l'identité, le contexte et l'historique gouverné qu'une continuité d'entreprise exige.
Lire l'article →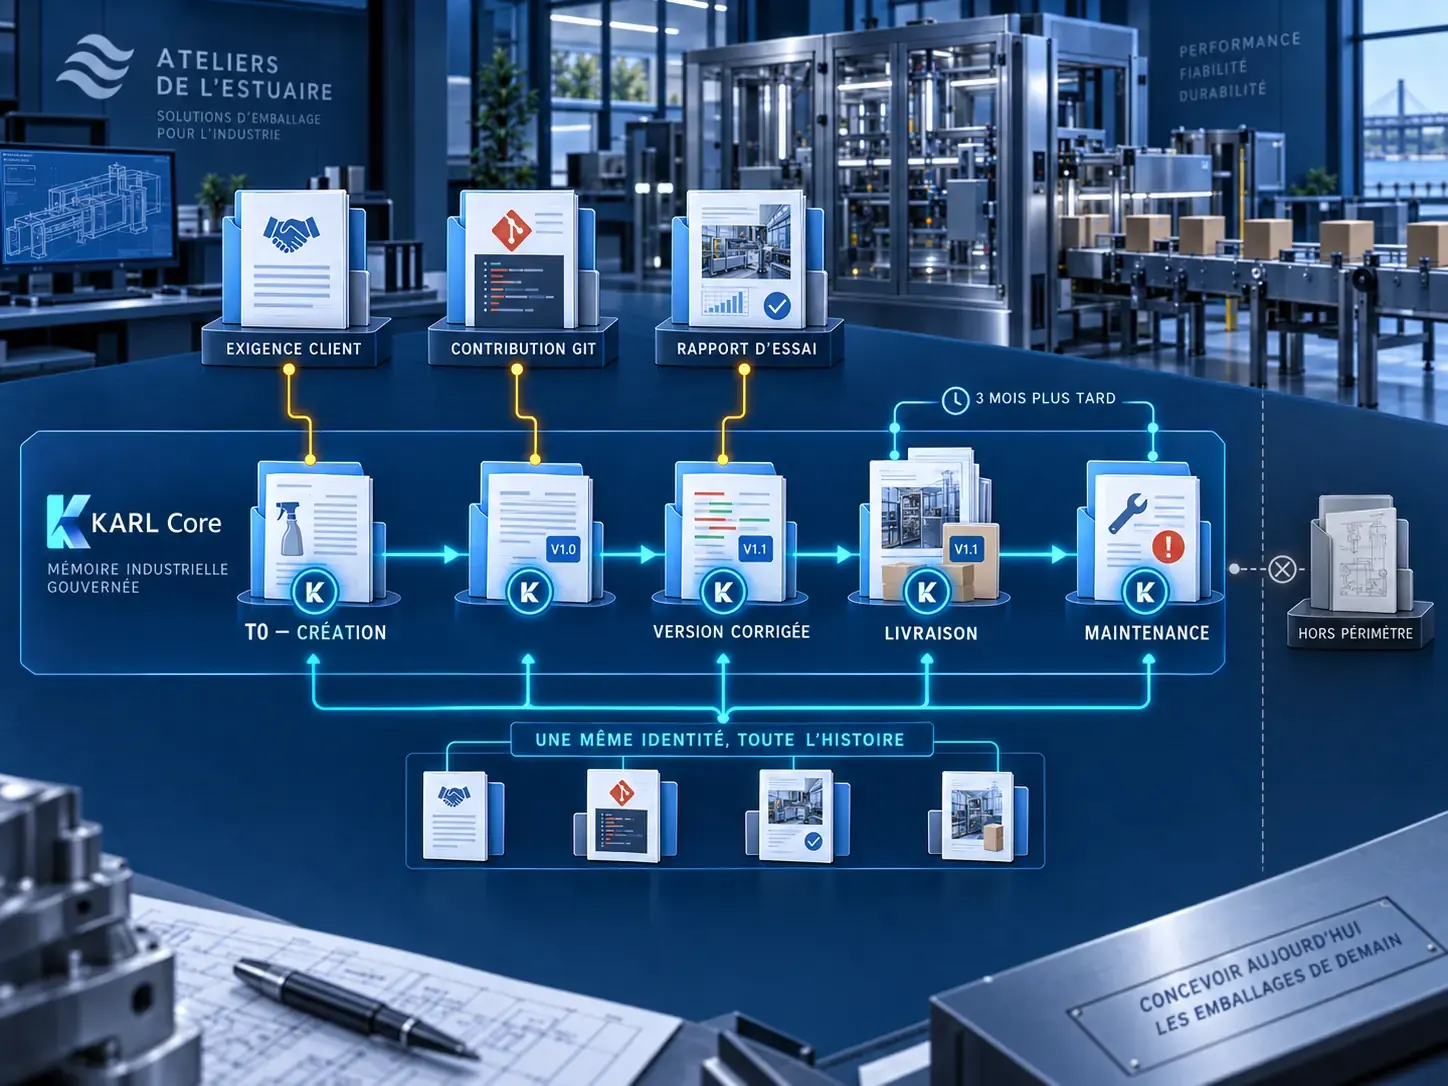
KARL Core : la mémoire d'entreprise commence à la création du fichier
Une mémoire d'entreprise prend de la valeur lorsqu'elle conserve, dès l'origine, les liens entre les données, leurs transformations et les décisions qui les concernent. KARL Core fournit les fondations de cette continuité.
Lire l'article →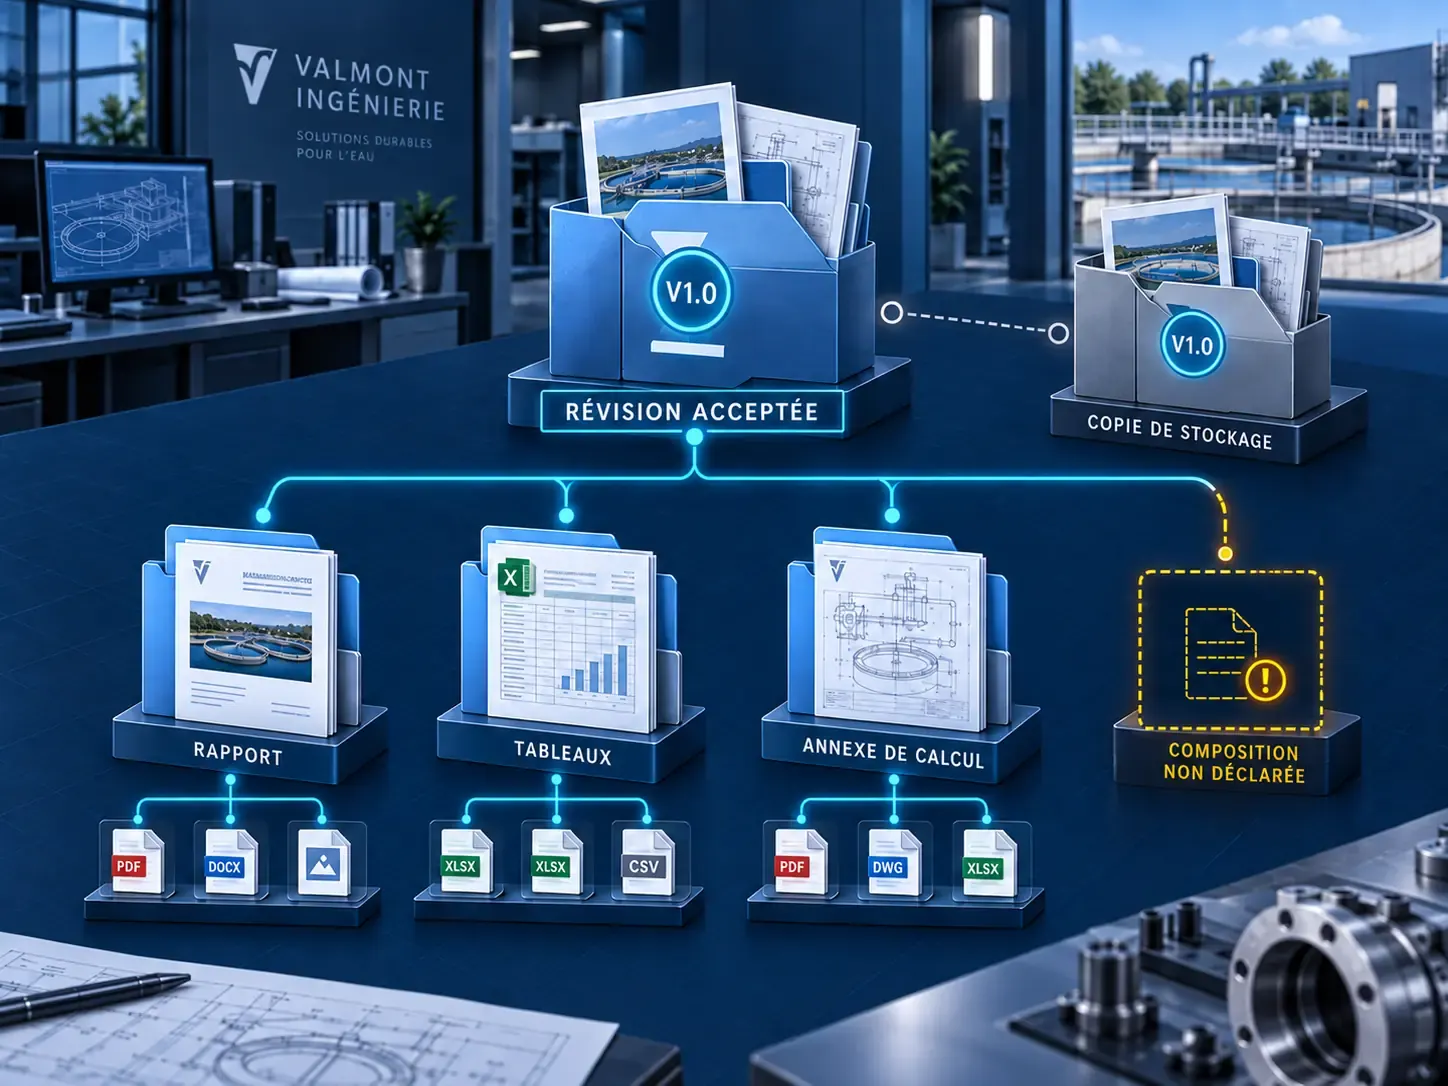
Savoir exactement ce que contient une livraison
Un dossier de livraison possède souvent plusieurs formes et pièces justificatives. KARL Core décrit les représentations d'un état précis et les composants qui leur sont associés.
Lire l'article →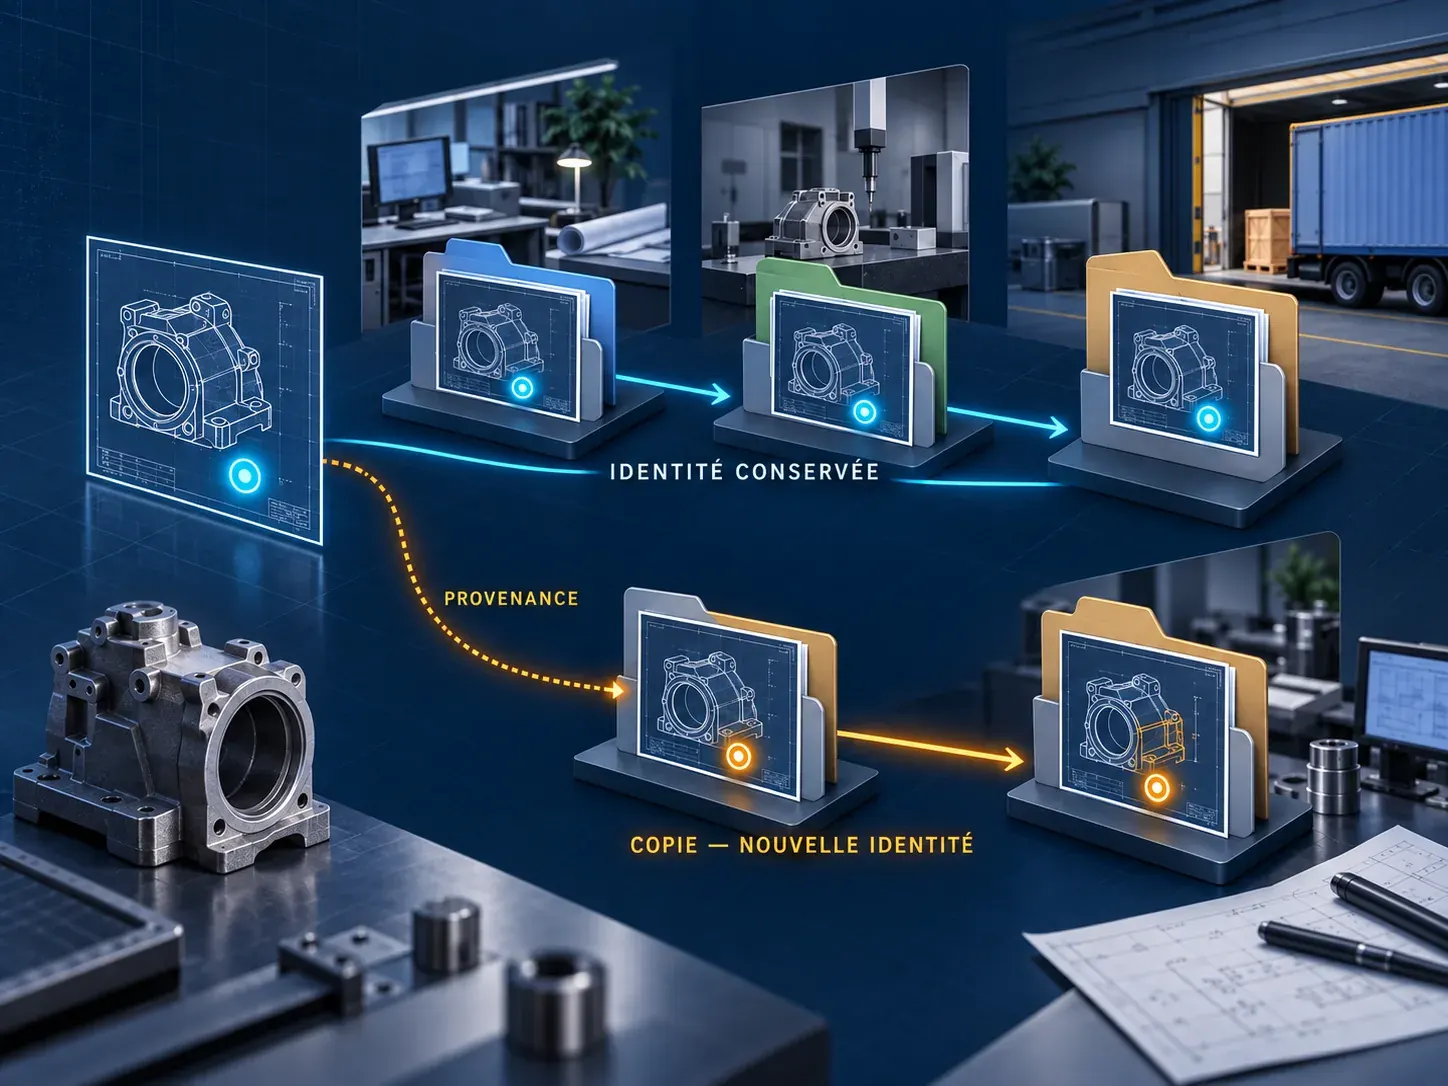
Un document change de nom. Son histoire doit rester lisible.
Un plan qui change de dossier plusieurs fois avant la livraison doit rester compréhensible. KARL Core distingue la ressource, son emplacement et les sources qui permettent de la retrouver.
Lire l'article →
Restaurable ne veut pas dire fiable
Après un ransomware, restaurer les systèmes est nécessaire mais ne répond pas à la question la plus difficile : quelles données restaurées peut-on réellement considérer comme fiables ?
Lire l'article →Quand le stockage S3 devient une question de gouvernance
Une décision prise par un agent ne se résume pas à sa réponse. Il faut pouvoir retrouver la donnée, la règle, l'autorisation et le contexte qui l'ont rendue possible. C'est l'angle choisi par StorageNewsletter pour présenter StratoFoundry.
Lire l'article →
Knowledge Layer, Memory Layer : de quoi parlons-nous exactement ?
Demandez à une équipe quelle politique s'appliquait à tel fournisseur lorsque son accès a été renouvelé au printemps : qui a validé, sur la base de quelles informations, avec quels droits. Les données existent, éparpillées ; la réponse, elle, n'existe nulle part. Knowledge Layer et Memory Layer
Lire l'article →
Des objets qui se portent tout seuls : aux origines de PanglotOS
En 1997, un mémoire d'ingénieur à l'EPITA proposait des objets répartis porteurs de leurs propres règles d'usage et de transformation, classées en trois boîtes : blanche, grise, noire. Vingt-neuf ans plus tard, cette intuition est devenue PanglotOS, un micro-noyau et un écosystème de plus de cent ci
Lire l'article →
Santé numérique : garantir l’intégrité et la disponibilité des données médicales dans le temps
La numérisation du secteur de la santé génère d’immenses volumes de dossiers patients, d’imageries diagnostiques et de flux de télémédecine. Deux exigences s'imposent : l’intégrité – la garantie que les informations ne sont ni altérées ni falsifiées – et la disponibilité – la capacité à accéder aux données en tout temps, même en cas d’incident majeur. Concilier ces impératifs avec le cadre régleme
Lire l'article →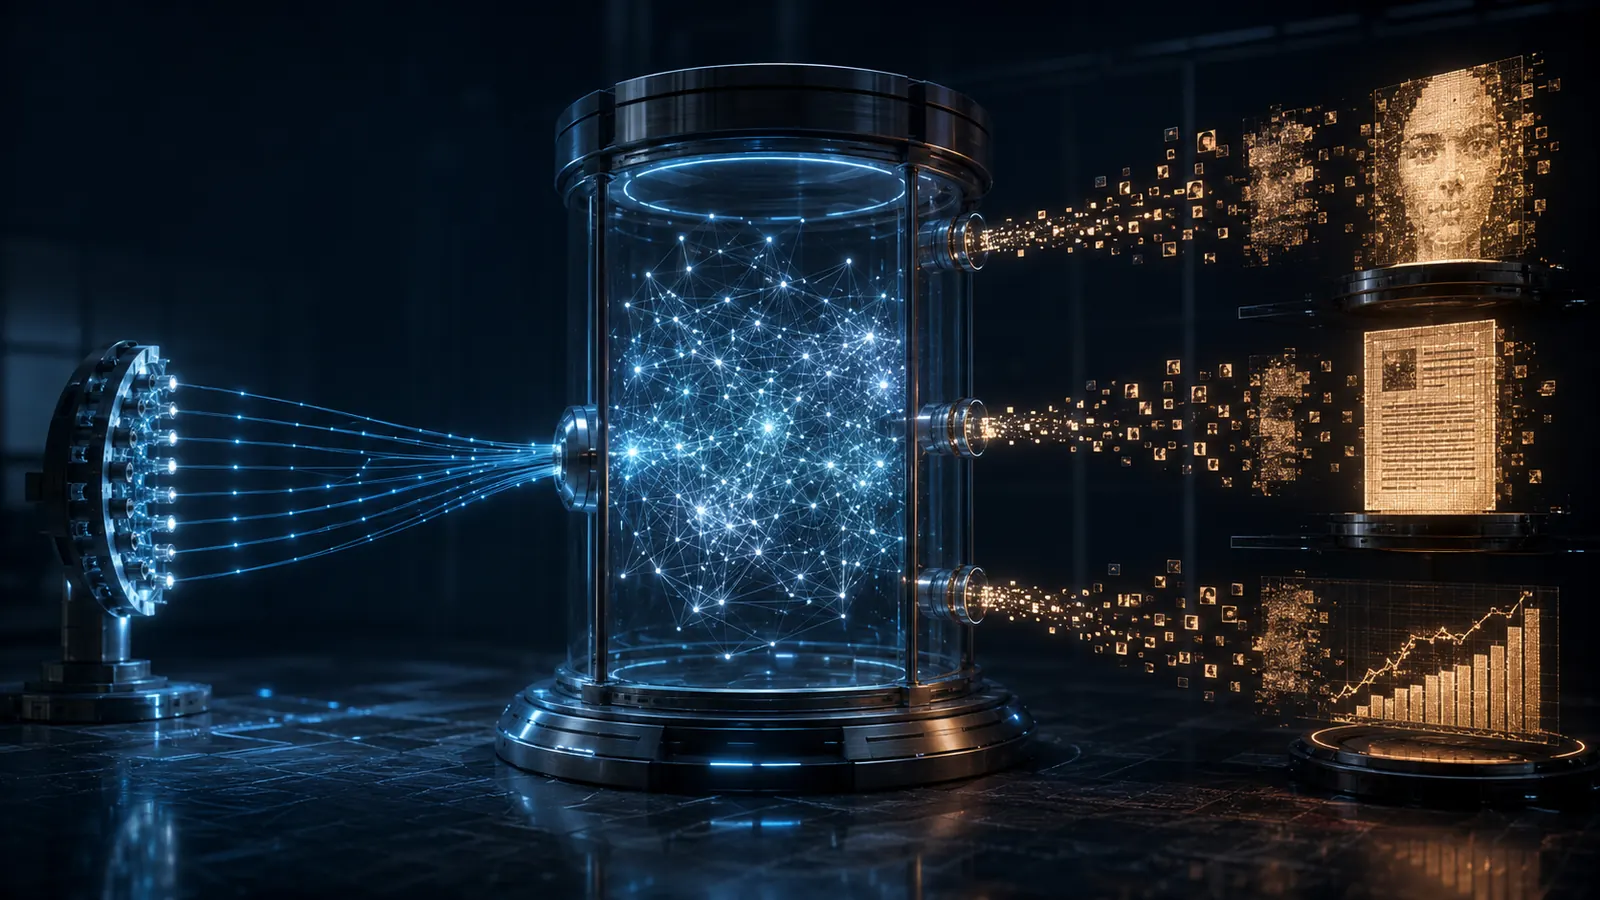
Model inversion : peut‑on extraire les données d’entreprise directement depuis un modèle ?
Les modèles d’apprentissage automatique sont devenus des actifs stratégiques pour les entreprises, qu’ils soient déployés en interne ou proposés comme services SaaS. Pourtant, la capacité de ces modèles à mémoriser des informations sensibles ouvre une nouvelle surface d’attaque : le model inversion. Cette technique permet, dans certains cas, de reconstruire des attributs privés (images, textes, p
Lire l'article →
Comment conserver les décisions d’une IA sans stocker indéfiniment les données qui les ont produites ?
Les systèmes d’intelligence artificielle prennent chaque jour des milliers de décisions – prêts à être approuvés, diagnostics médicaux, recommandations financières. La traçabilité de ces décisions devient une exigence réglementaire (RGPD, ISO 27001) et un levier de confiance pour les parties prenantes. Or, conserver l’ensemble des jeux de données d’entraînement ou les logs bruts pose des problèmes
Lire l'article →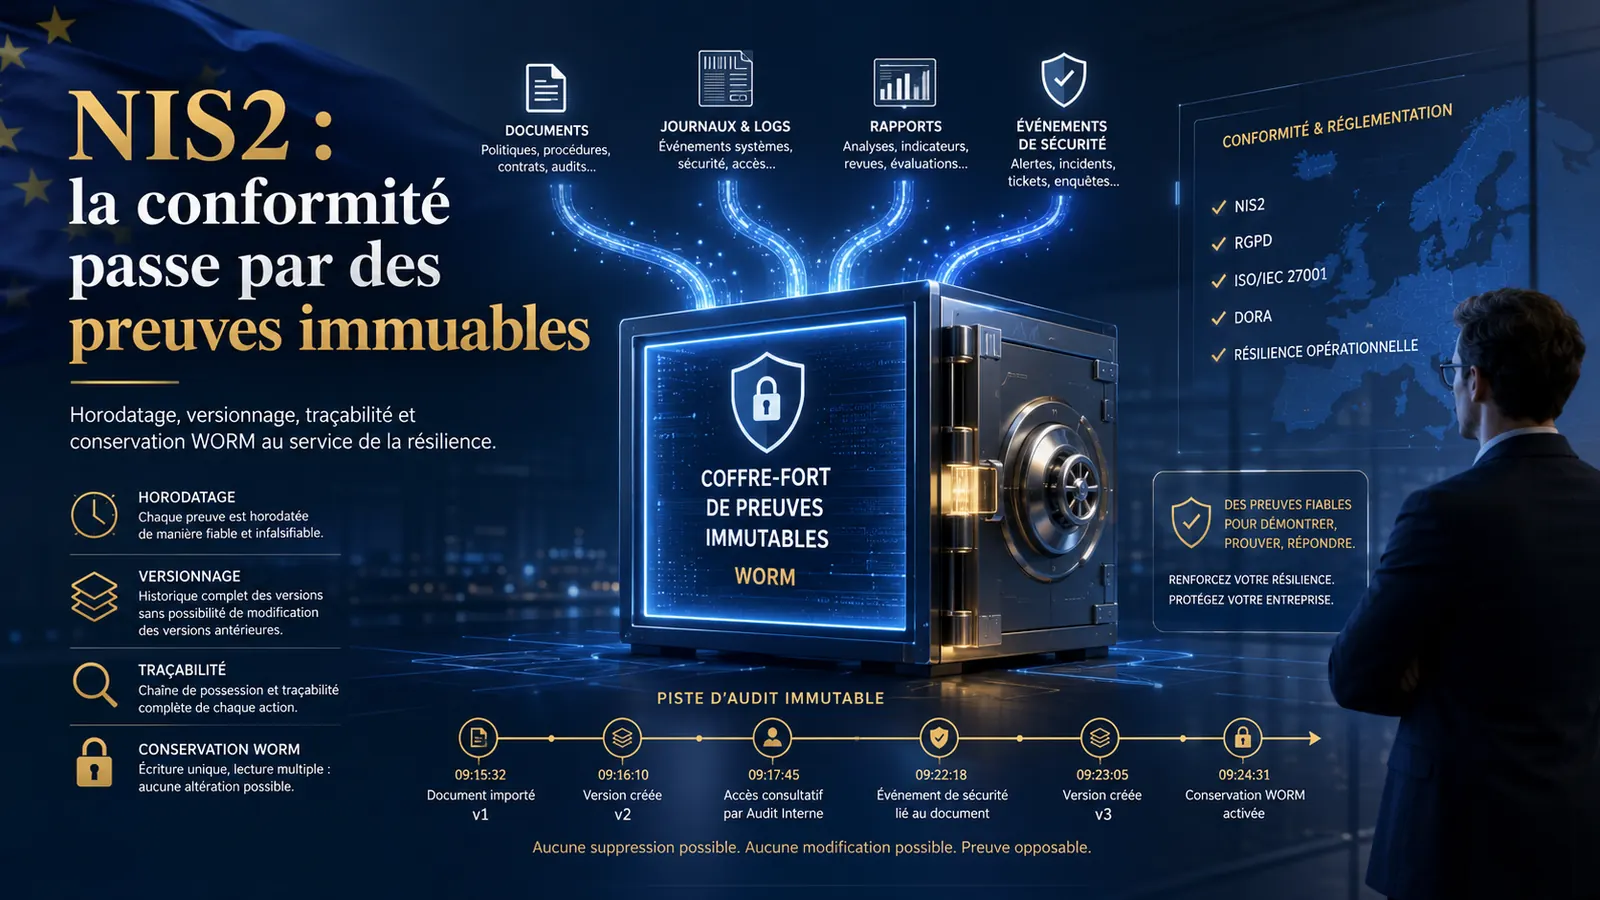
NIS2 : la conformité passe par des preuves immuables
La directive NIS2 ne se contente plus d'exiger la mise en place de mesures de sécurité : elle impose de prouver que chaque action a été réalisée. Une chaîne de conservation fondée sur l'horodatage, le versionnage et le stockage WORM devient indispensable pour les entités essentielles et importantes.
Lire l'article →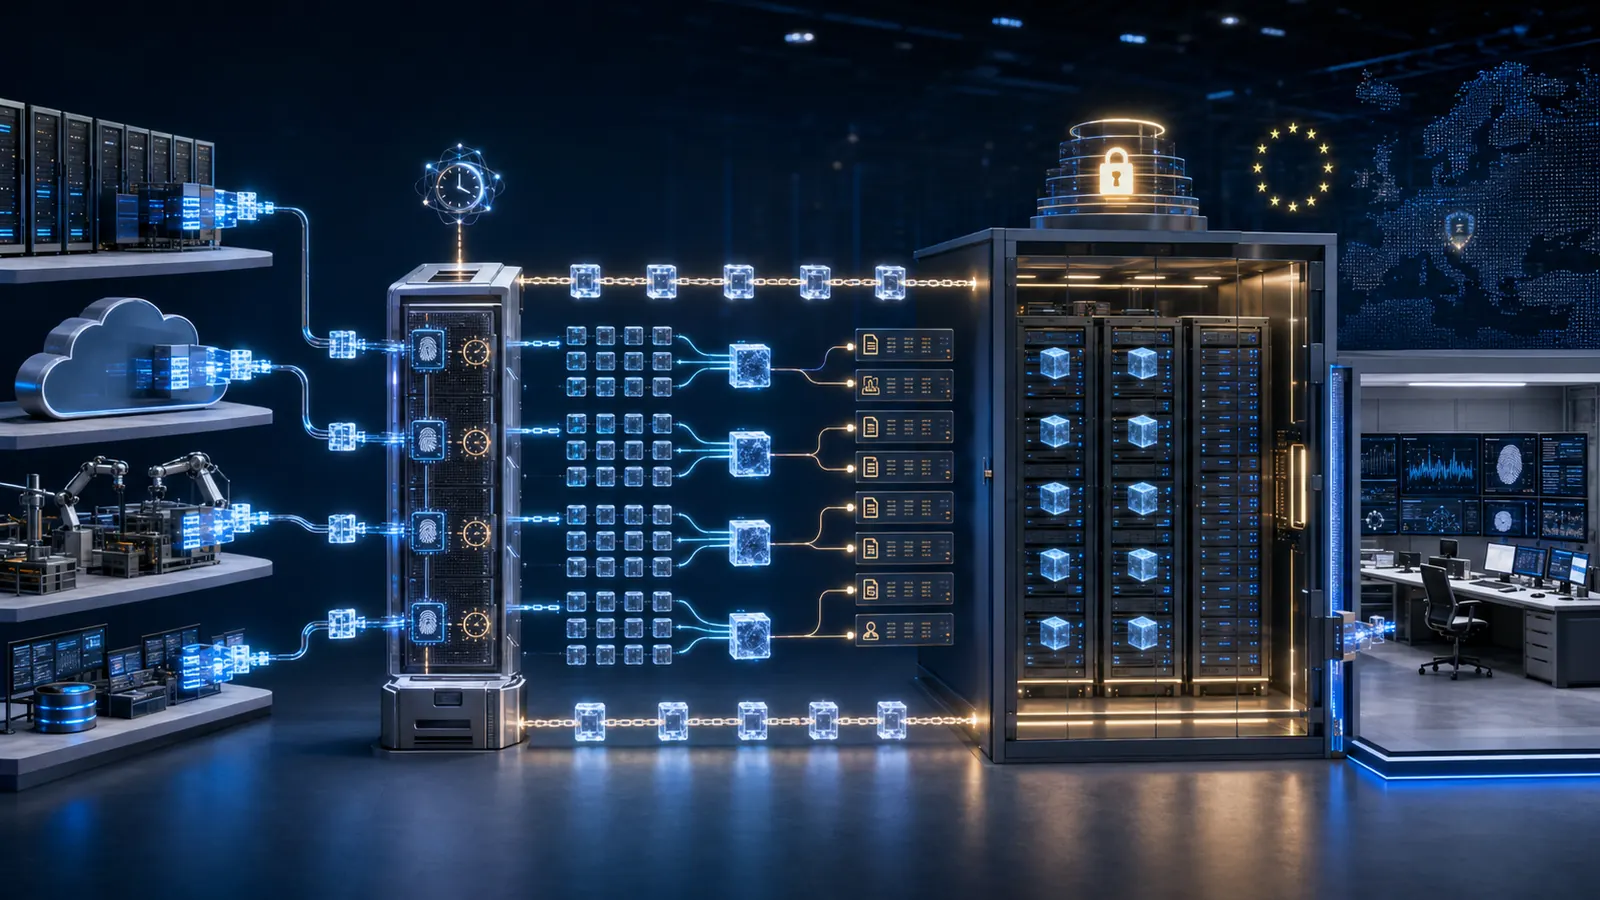
Architecture immuable pour la preuve NIS2 : WORM, S3 et chaîne horodatée
La directive NIS2 exige de transformer chaque action de sécurité en preuve fiable, horodatée et immuable. Combiner le stockage WORM, les buckets S3 Object Lock et une chaîne de conservation cryptographique crée un pipeline complet de preuve juridiquement acceptable, indispensable lors d'audits ou d'investigations forensiques.
Lire l'article →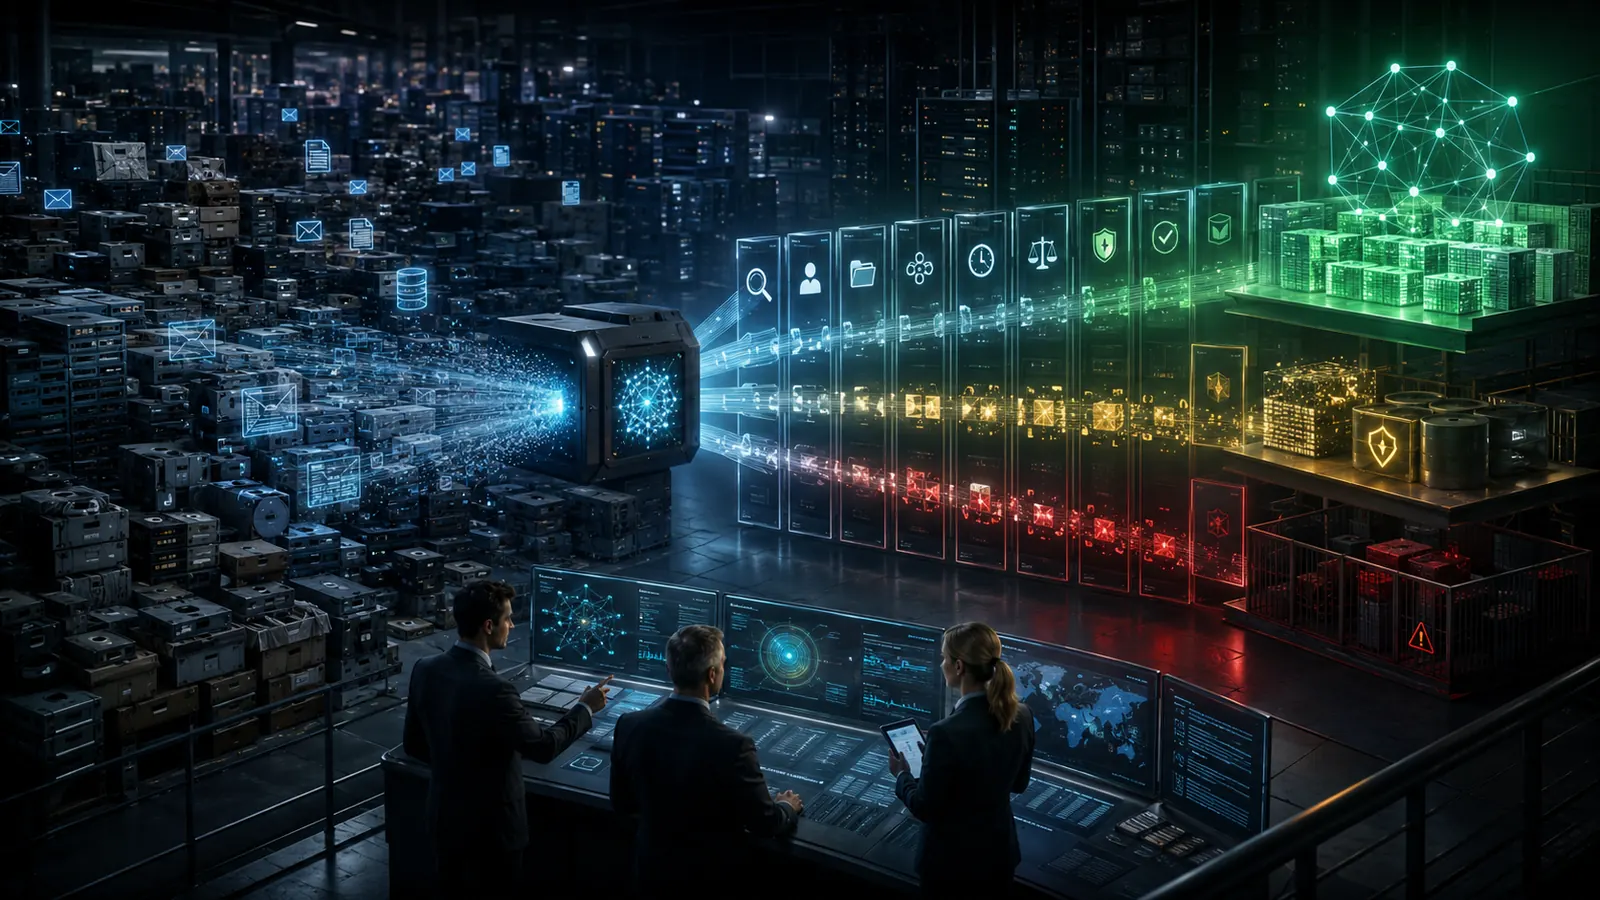
Dark data : l’IA peut‑elle exploiter les archives que l’entreprise ne sait plus gouverner ?
Les organisations accumulent chaque jour des pétaoctets de données dites « dark data » : fichiers, logs, courriels ou bases obsolètes qui échappent aux processus de gouvernance. Si ces actifs restent inexploités, ils constituent un coût caché et un risque juridique, mais ils recèlent également une richesse d’informations potentiellement exploitable par l’intelligence artificielle. Cet article anal
Lire l'article →
Migration monolithe vers microservices : audit fichiers conforme NIS2
Les monolithes legacy écrivent leurs journaux d'audit sur disque local — la traçabilité juridique est souvent insuffisante. Migrer ces flux vers un stockage S3 avec Object Lock, versionning et SDK Rust permet de bénéficier de l'immuabilité juridique tout en réduisant les coûts d'exploitation.
Lire l'article →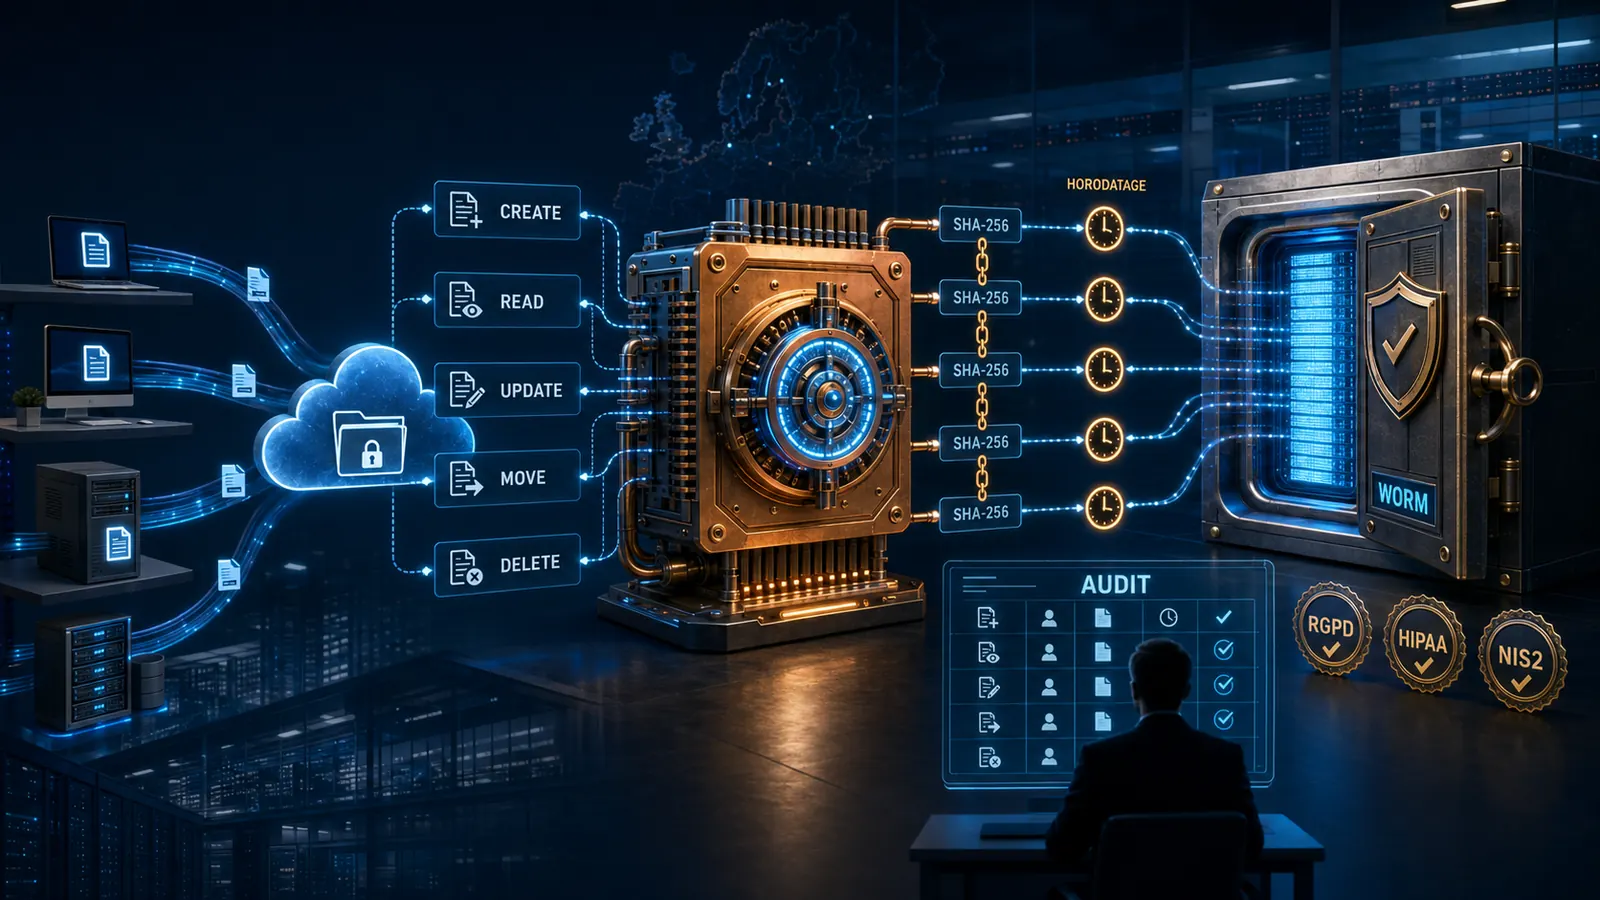
Concevoir des opérations fichiers auditées pour le cloud
Les organisations doivent non seulement sécuriser les données dans le cloud, mais prouver que chaque opération de fichier est conforme aux règles. Cet article explique comment construire une bibliothèque Rust d'audit immuable produisant une chaîne de preuves exploitable en audit.
Lire l'article →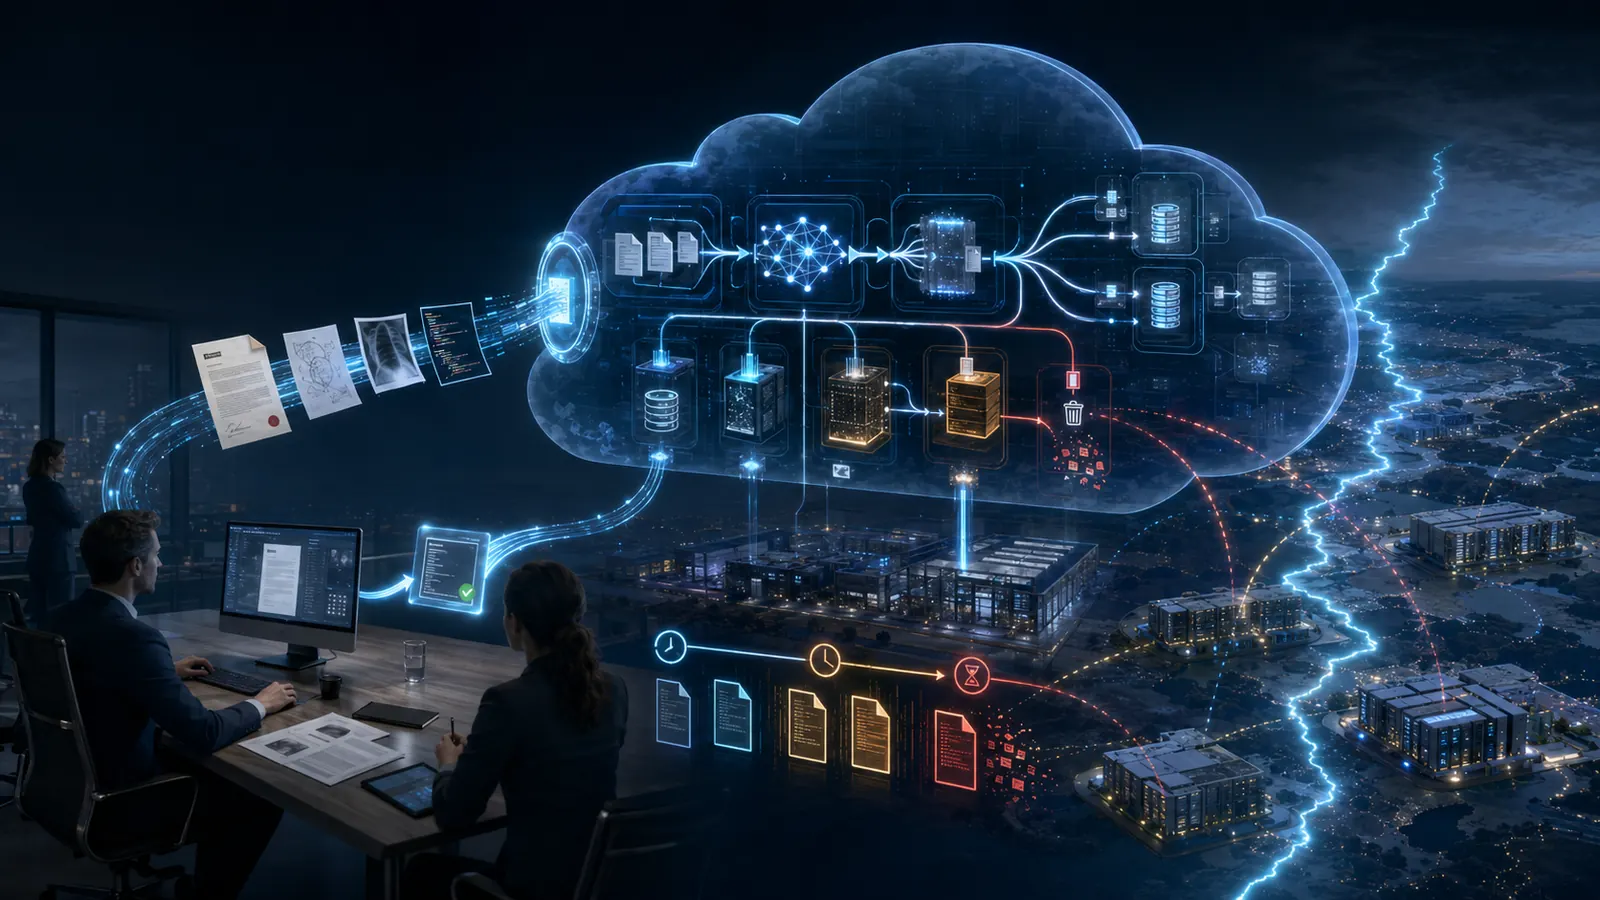
Cloud public et IA générative : où partent réellement les documents soumis au modèle ?
Les services d’IA générative hébergés sur les clouds publics (OpenAI, Azure OpenAI, AWS Bedrock, Google Vertex AI…) traitent chaque jour des millions de fichiers texte, images ou code source. Pour les organisations qui y confient leurs données sensibles – contrats, brevets, dossiers patients – la question n’est plus seulement « le modèle peut‑il répondre correctement<0xE2><0x80><0
Lire l'article →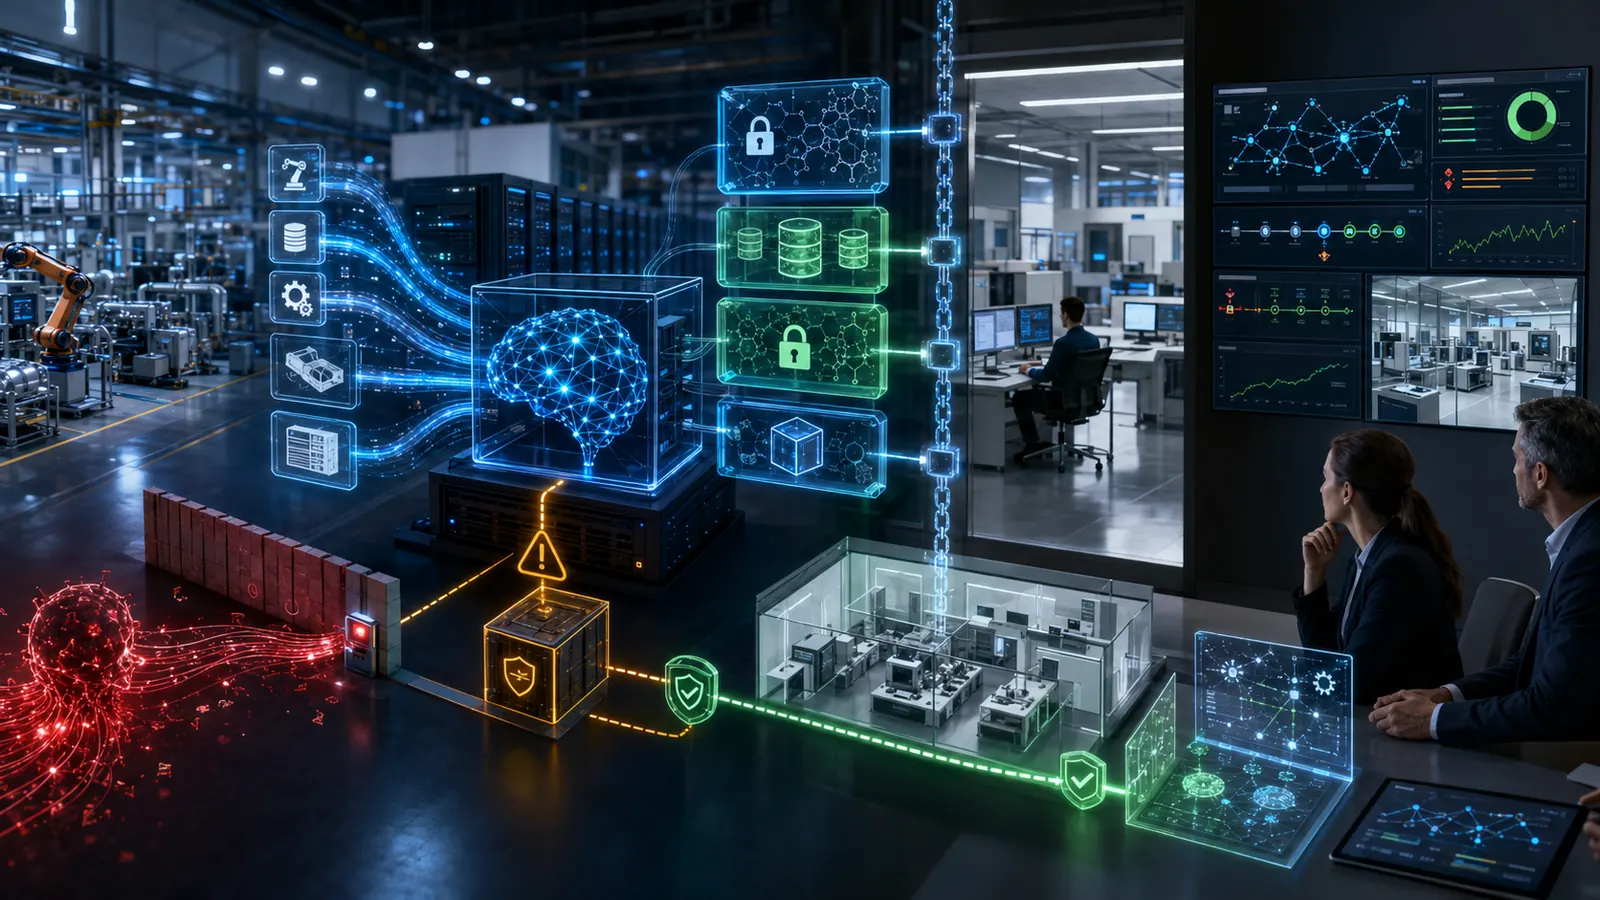
Cyberassurance et intelligence artificielle : comment prouver que les données critiques sont protégées et restaurables ?
Face à la multiplication des attaques ciblant l’intégrité et la disponibilité des informations, les assureurs exigent aujourd’hui des preuves tangibles de résilience. L’intelligence artificielle (IA) apparaît comme un levier pour automatiser la surveillance, optimiser les stratégies de sauvegarde et générer les artefacts requis aux audits d’assurance cyber. Cet article décrit le cadre réglementair
Lire l'article →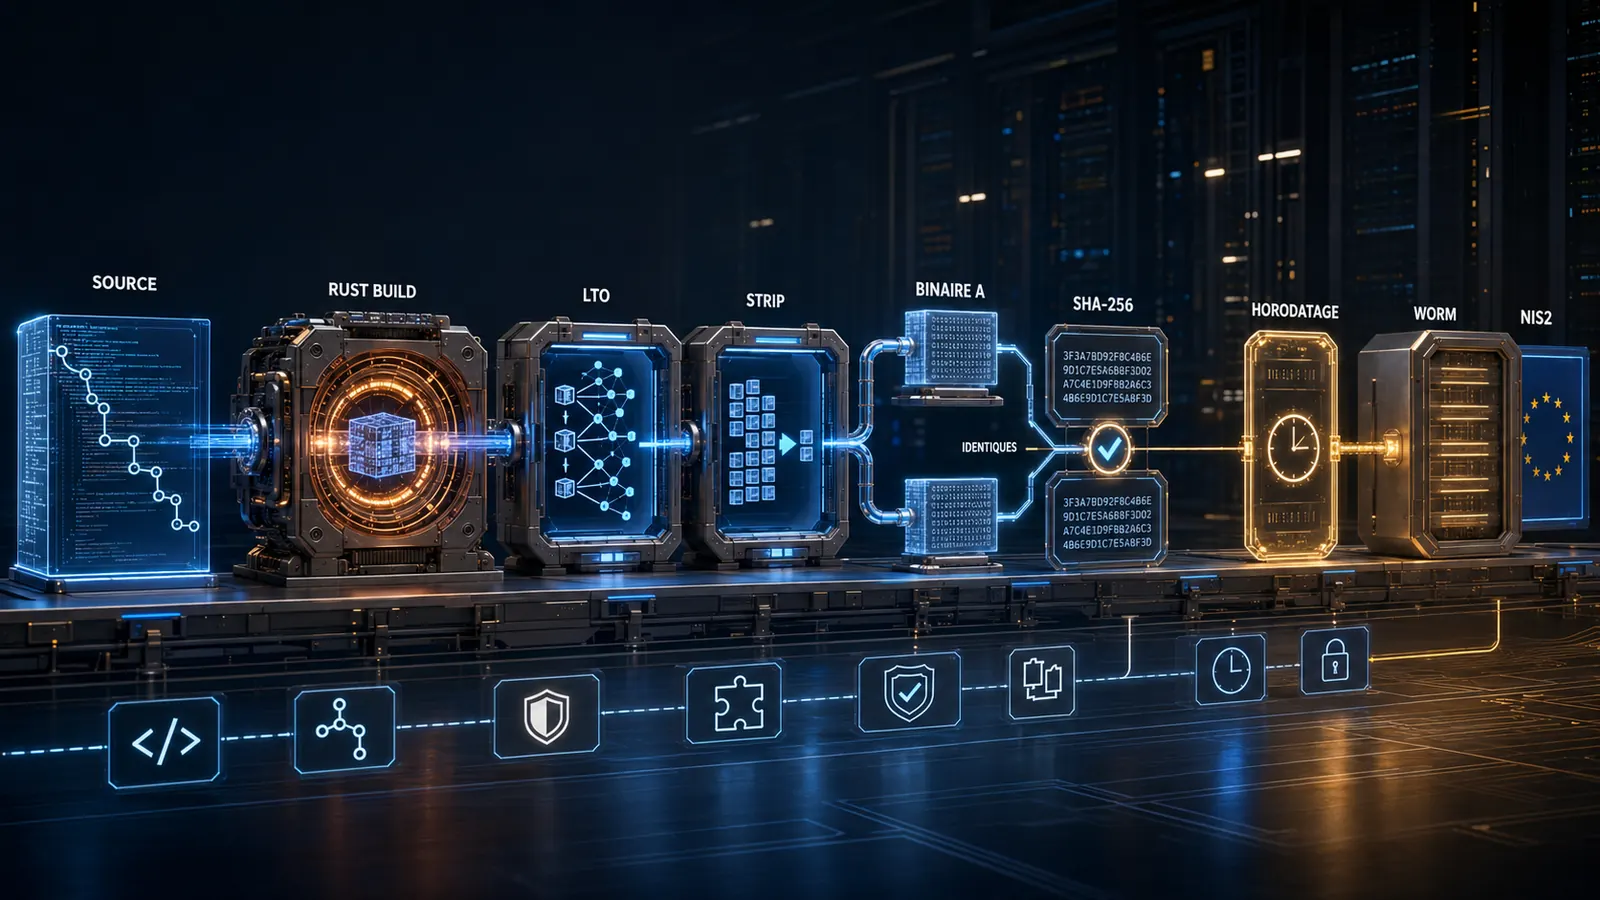
Binaires Rust déterministes avec LTO et strip pour NIS2
Les binaires Rust optimisés avec Link-Time Optimisation (LTO) et strip offrent une meilleure posture de sécurité : suppression des symboles inutiles, réduction de la surface d'attaque, et garantie que le même code source génère toujours le même binaire. Cet article décrit la configuration des profils release pour créer des preuves exploitables lors d'un audit NIS2.
Lire l'article →
Clés de chiffrement : pourquoi les données et les moyens de les déchiffrer doivent rester séparés
Chapô – Dans un contexte où la fuite ou la compromission de données sensibles entraîne des pertes financières, juridiques et réputationnelles majeures, le chiffrement apparaît comme le rempart incontournable. Pourtant, chiffrer les données ne suffit pas : la vraie sécurité réside dans la séparation stricte entre les informations protégées et les secrets qui permettent leur déchiffrement. Cette dis
Lire l'article →
Fondations async I/O Tokio pour des alertes temps réel conformes NIS2
Dans les environnements critiques, la détection et la diffusion d'une alerte en microsecondes est un facteur de résilience. Combiner le runtime Tokio avec une chaîne de conservation immuable (horodatage qualifié, hash SHA-256, stockage WORM) transforme chaque événement en preuve auditable exigée par NIS2.
Lire l'article →
Données industrielles et IoT : transformer les flux terrain en données d’IA fiables et opposables
L’Internet des objets industriels (IIoT) génère chaque jour des pétaoctets de mesures provenant de capteurs, d’automates programmables et de systèmes embarqués. Ces flux bruts constituent une mine d’informations pour l’intelligence artificielle, mais leur valeur dépend entièrement de la capacité à les rendre fiables, traçables et opposables devant un audit ou une instance juridique. Cet article dé
Lire l'article →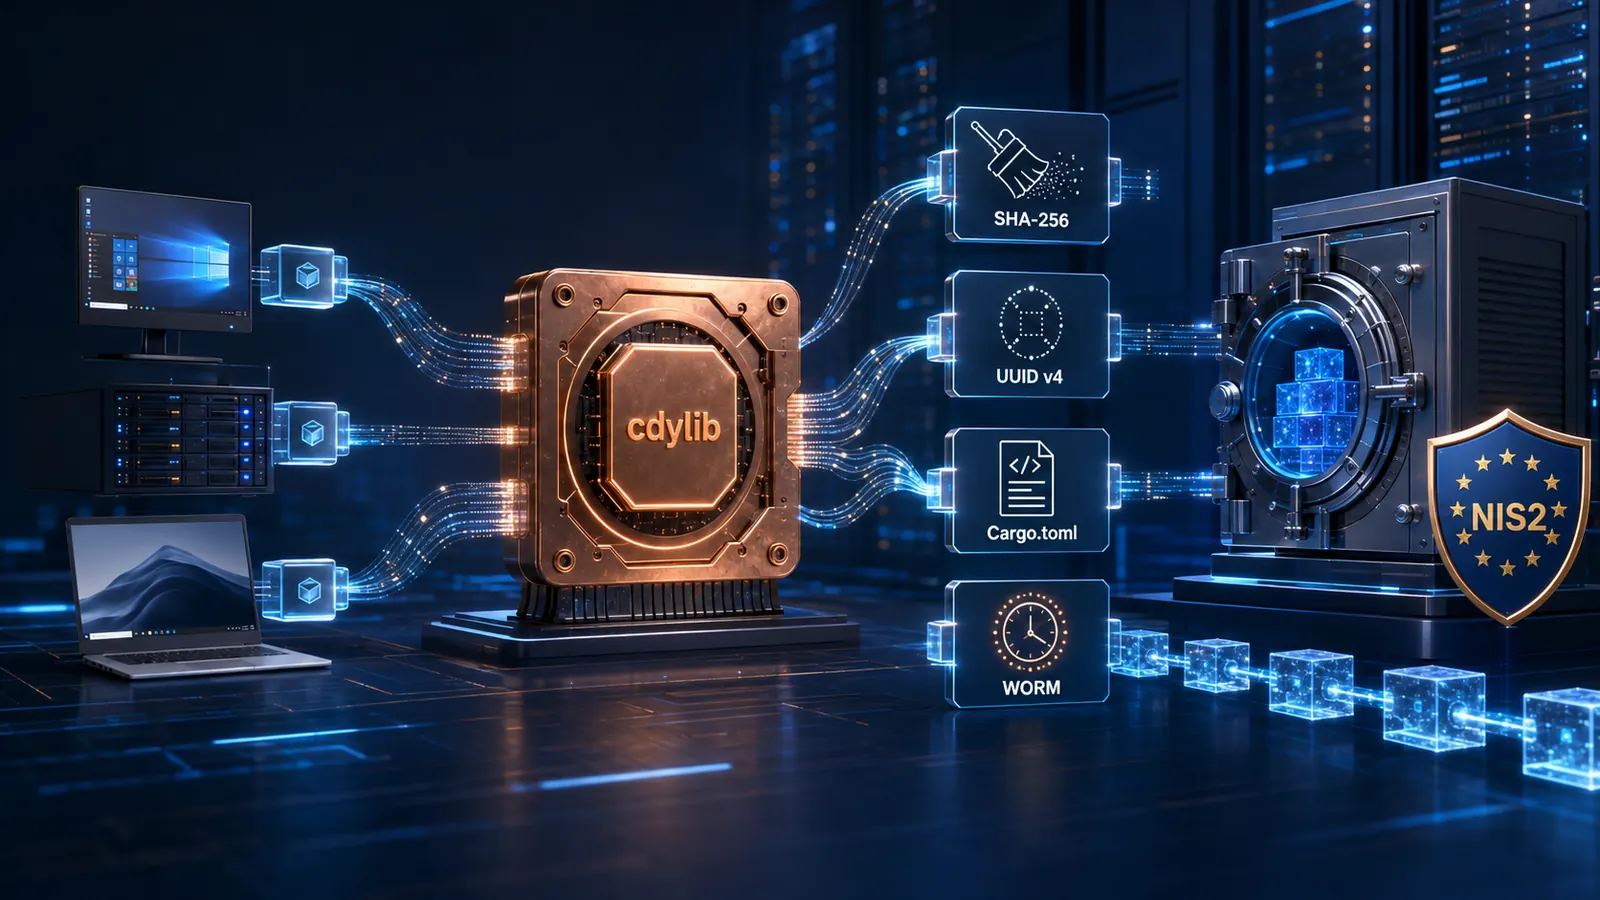
Extensions natives multiplateformes avec cdylib Rust pour NIS2
Les extensions natives compilées en bibliothèques dynamiques (cdylib) Rust combinent haute performance et portabilité C-compatible. Combinées aux primitives cryptographiques Rust (zeroize, SHA-256, UUID v4), elles permettent de livrer des plugins répondant aux exigences techniques ET aux exigences de traçabilité juridique imposées par NIS2.
Lire l'article →
Défense contre le ransomware sans reconstruction complète
Les organisations ne peuvent plus se contenter de restaurer les systèmes en repartant de zéro après un ransomware. NIS2 exige la capacité de prouver chaque action décidée, exécutée, contrôlée et conservée immuablement. Comment défendre son environnement contre le rançonnage tout en satisfaisant ces exigences sans réinstaller son infrastructure ?
Lire l'article →
Durées de conservation : faut‑il supprimer une donnée encore présente dans un modèle entraîné ?
En Europe, le Règlement général sur la protection des données (RGPD) impose aux responsables de traitement de respecter des durées de conservation strictes. Or, les modèles d’intelligence artificielle (IA) conservent souvent, sous forme de paramètres, des traces indétectables de chaque observation utilisée pour l’apprentissage. Cette dualité soulève une question cruciale : lorsqu’une donnée person
Lire l'article →Alertes comportementales sécurisées et traçables en Rust
La directive NIS2 impose une preuve fiable pour chaque mesure de cybersécurité. Un plugin SSA (Secure Behavioural Alerts) écrit en Rust illustre comment la robustesse du langage combinée à des mécanismes d'immuabilité (horodatage, versionnage, traçabilité) transforme chaque alerte en élément de preuve exploitable lors d'un audit ou d'une investigation.
Lire l'article →Chiffrement zero-knowledge pour plugins d'alertes en Rust
NIS2 impose de pouvoir démontrer ses mesures de cybersécurité. La confidentialité des données circulant dans les systèmes d'alerte devient un enjeu critique. Cet article décrit les primitives cryptographiques Rust (zeroize, SHA-256, UUID v4) intégrées dans un plugin qui crée des payloads confidentiels sans jamais exposer la clé de chiffrement.
Lire l'article →
IA embarquée et edge computing : comment synchroniser des données produites loin du système central ?
L’essor de l’intelligence artificielle embarquée au plus près des capteurs – le edge computing – transforme la façon dont les organisations collectent, analysent et exploitent leurs données. Mais cette décentralisation soulève un problème majeur : comment garantir que les informations générées en périphérie soient correctement synchronisées avec les systèmes centraux, sans perdre de fiabilité, de
Lire l'article →
La suppression d’un fichier suffit‑elle lorsqu’il subsiste dans un index vectoriel, un cache et une sauvegarde ?
Chapô – Dans le cadre du droit à l’oubli ou de la gestion rigoureuse des données sensibles, les organisations s’interrogent souvent : « Supprimer le fichier source est‑il suffisant ? ». En pratique, le même document peut être présent simultanément dans un système de stockage primaire, un index vectoriel d’IA, plusieurs niveaux de cache et une chaîne de sauvegarde. Cette redondance technique compli
Lire l'article →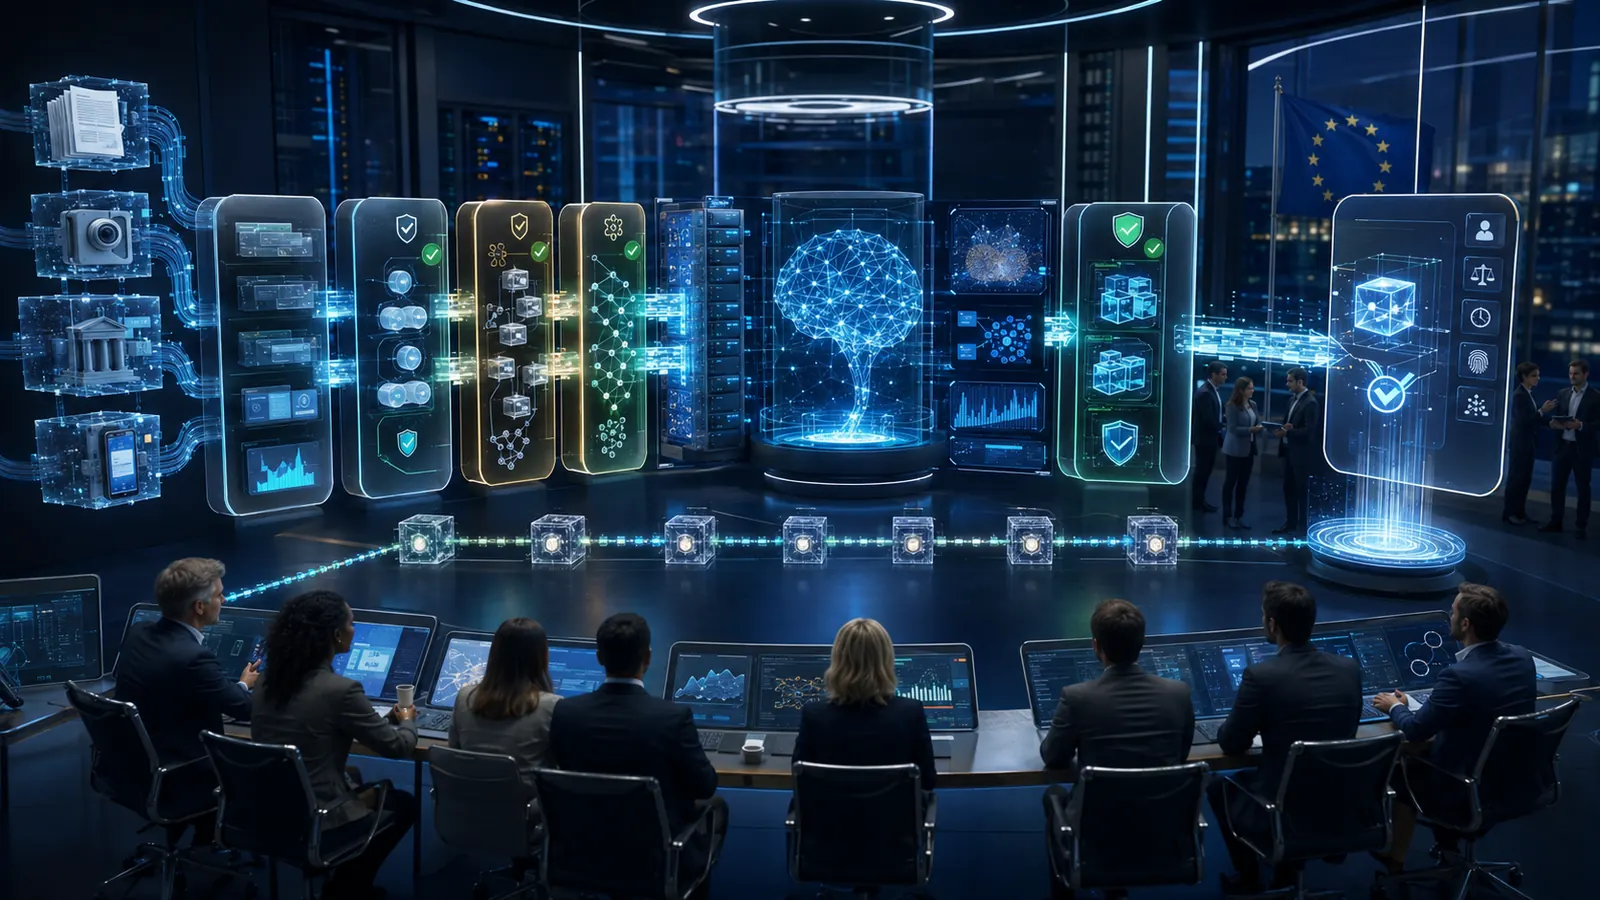
De la donnée brute à la décision automatisée : pourquoi l’entreprise a besoin d’une chaîne de conservation complète
Chapô – Dans un contexte où les algorithmes d’intelligence artificielle (IA) pilotent une part croissante des processus métier, la simple collecte de données brutes ne suffit plus. La capacité d’une organisation à tracer, sécuriser et conserver chaque fragment de donnée tout au long de son cycle de vie devient le socle indispensable pour garantir la fiabilité des modèles, la conformité réglementai
Lire l'article →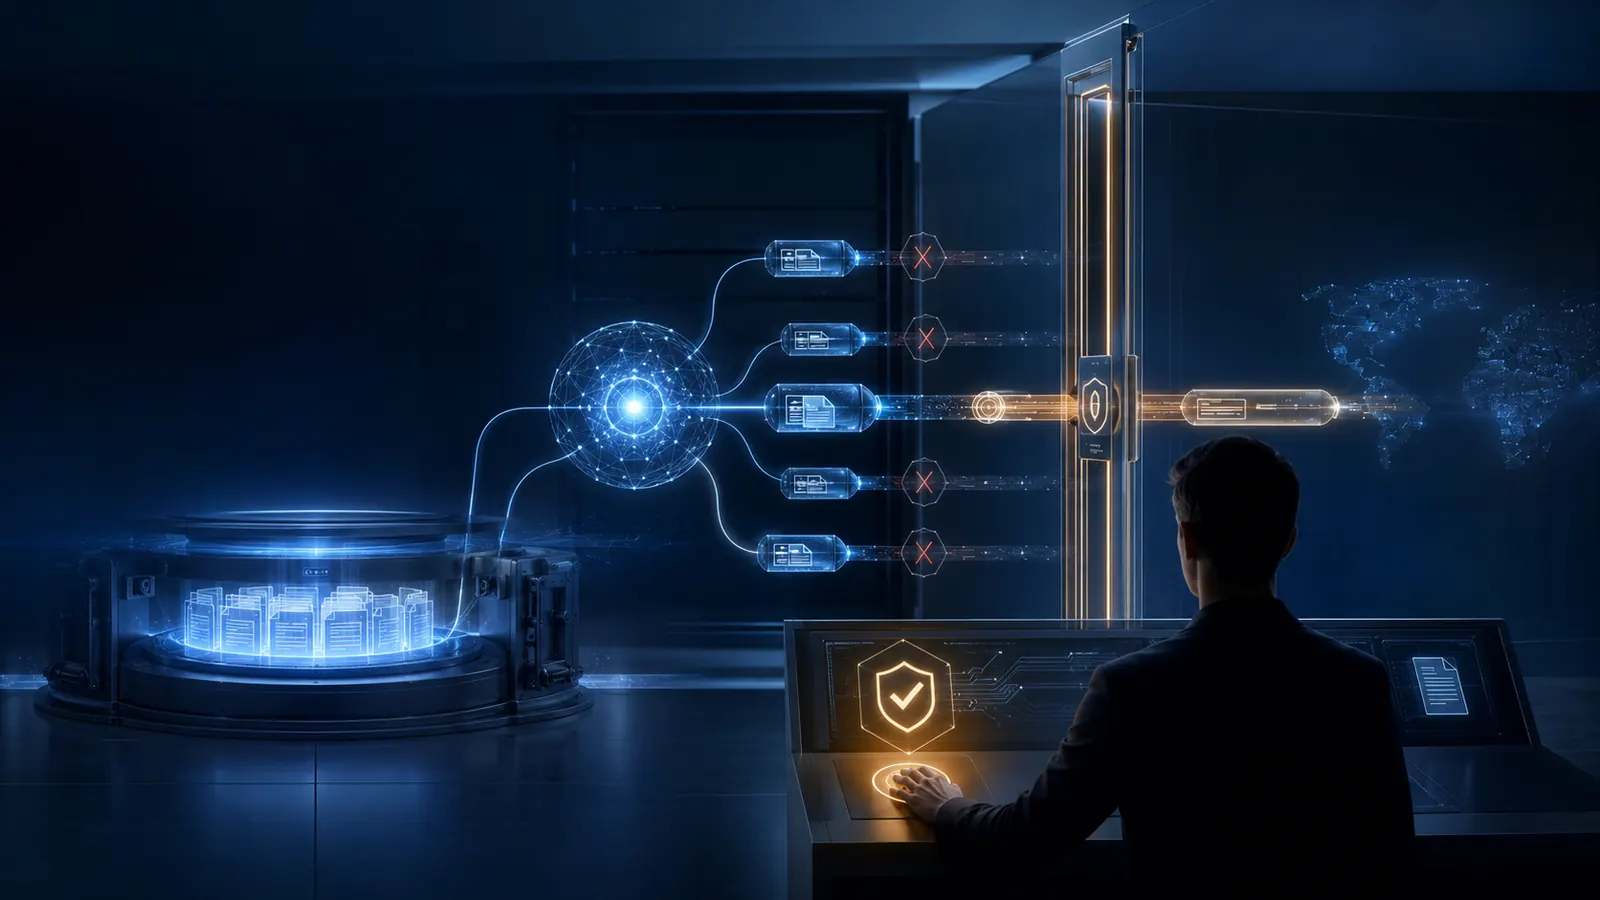
Agents autonomes : comment empêcher une IA de déplacer ou de divulguer des données sans validation humaine ?
Les agents logiciels dotés d’une capacité décisionnelle autonome (chat‑bots, orchestrateurs de flux, systèmes de recommandation…) sont de plus en plus intégrés aux environnements critiques. Leur puissance réside dans la rapidité avec laquelle ils peuvent analyser, transformer et transmettre des données ; mais cette même autonomie crée le risque qu’ils déplacent ou exposent des informations sensibl
Lire l'article →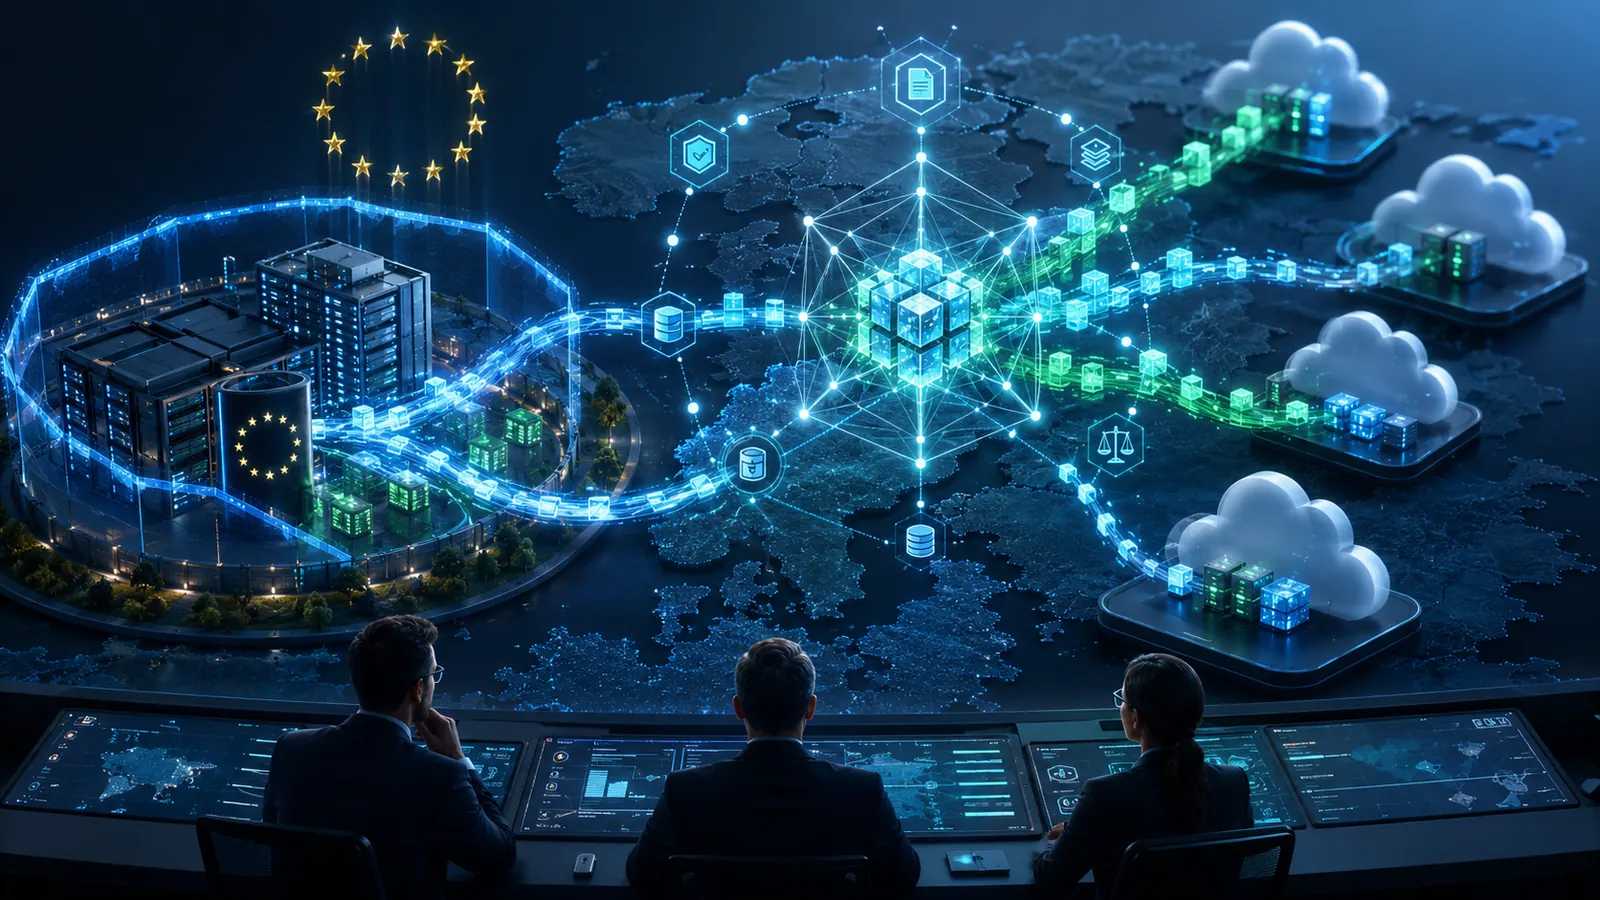
Data Fabric hybride multi‑cloud : orchestrer la réplication sécurisée entre souveraineté européenne et fournisseurs publics
Alors que les organisations européennes multiplient leurs environnements cloud – souverains pour répondre aux exigences de résidence des données, publics pour profiter d’économies d’échelle – le besoin d’un Data Fabric hybride capable d’orchestrer la réplication sécurisée devient stratégique. Ce dispositif doit concilier souveraineté, performance, résilience et conformité (RGPD, NIS2) tout en rest
Lire l'article →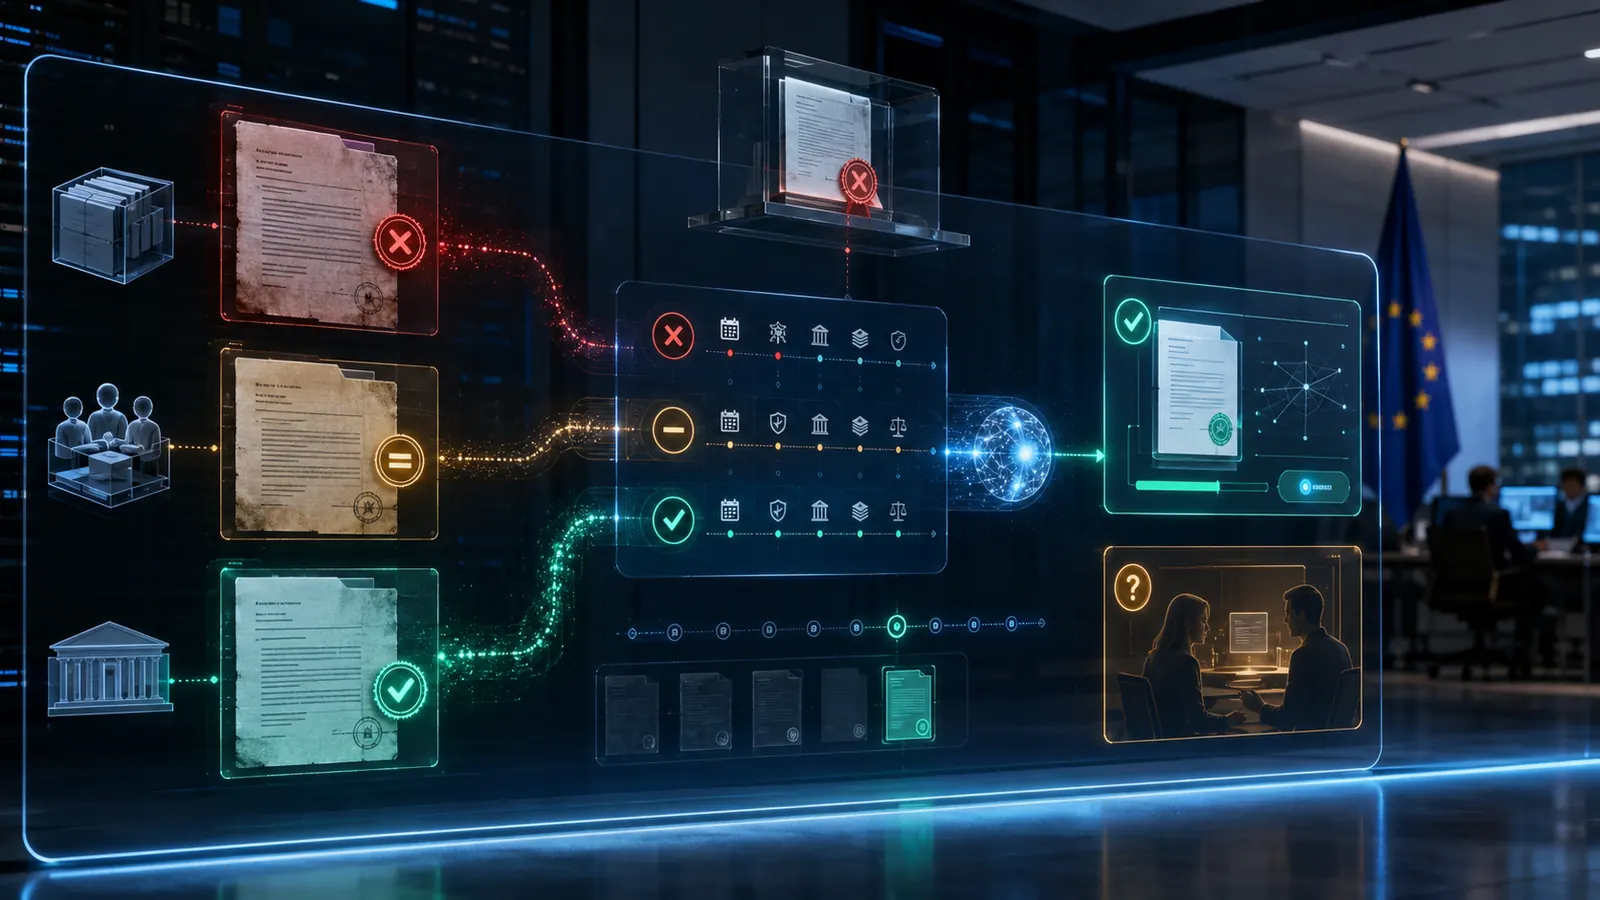
Documents contradictoires : comment empêcher une IA de présenter une ancienne procédure comme une vérité actuelle ?
Chapô – Les modèles de langage génératif (LLM) sont aujourd’hui intégrés aux systèmes d’assistance, de documentation et de prise de décision. Leur capacité à synthétiser l’information les rend précieux, mais ils peuvent aussi restituer des procédures périmées ou en conflit avec la version officielle en vigueur. Ce risque, souvent masqué par la fluidité du texte produit, menace la conformité réglem
Lire l'article →
Panne ou compromission : comment restaurer une plateforme d’IA dans un état antérieur fiable ?
Les plateformes d’intelligence artificielle (IA) sont aujourd’hui au cœur des services numériques, de la recommandation produit à l’aide décisionnelle en temps réel. Leur indisponibilité ou leur altération – qu’elle résulte d’une défaillance technique ou d’une compromission malveillante – peut entraîner une perte de confiance, des coûts opérationnels majeurs et des risques juridiques. Restaurer ce
Lire l'article →
ETI et PME : obtenir une conformité grand compte sans budget grand compte
Les exigences de conformité s'appliquent désormais à toutes les organisations, y compris les ETI et les PME. Pourtant, leurs budgets ne suivent pas. Comment construire une chaîne documentaire auditable, traçable et immuable sans dépenser des centaines de milliers d'euros ?
Lire l'article →IA et traçabilité des prompts : préparer l'EU AI Act
L'EU AI Act impose progressivement aux organisations de tracer, documenter et auditer leurs usages de l'IA. Cette obligation transforme les prompts, les modèles et les sorties en éléments de preuve qui doivent être historisés, immuables et restituables.
Lire l'article →Vendor lock‑in : quand la mémoire de l’entreprise devient dépendante d’un moteur d’IA propriétaire
L’avènement des grands modèles de langage (LLM) et des services d’inférence hébergés a ouvert un nouveau type de verrouillage : la capacité même d’une organisation à stocker, retrouver et exploiter son patrimoine informationnel repose désormais sur un moteur d’intelligence artificielle propriétaire. Ce phénomène, souvent masqué derrière les promesses de productivité, soulève des questions techniqu
Lire l'article →Immutabilité : l'arme ultime contre la corruption documentaire
Aucune politique de sécurité ne peut empêcher totalement la corruption des données. Mais l'immutabilité empêche cette corruption d'être permanente. C'est la propriété la plus sous-estimée des architectures de stockage modernes, et probablement la plus stratégique.
Lire l'article →Pourquoi Challenges parle de KARL ?
Retour sur l'article de Challenges consacré à KARL : pourquoi la gestion du temps dans les données devient un enjeu stratégique de résilience, de conformité et de mémoire documentaire pour les entreprises.
Lire l'article →
Les données non sensibles peuvent-elles, par recoupement, révéler des informations confidentielles ?
Dans un contexte où la collecte massive de données est devenue la norme, les organisations se demandent souvent si les jeux d’informations publiquement accessibles ou jugés « non sensibles » représentent réellement un risque. Loin d’être anodines, ces données peuvent, lorsqu’elles sont croisées avec d’autres sources, permettre de reconstituer des profils détaillés, voire de dévoiler des secrets d’
Lire l'article →Souveraineté numérique : reprendre le contrôle de ses données
La souveraineté numérique n'est plus un débat philosophique : c'est une exigence concrète, dictée par les régulateurs, les clients et les administrateurs. Reprendre le contrôle de ses données implique des choix d'architecture clairs.
Lire l'article →S3 natif : pourquoi supprimer les bases de données intermédiaires
La plupart des systèmes de coffre-fort numérique reposent sur une base de données intermédiaire qui dédouble l'information. Cette architecture introduit des risques, des coûts et des limites de scalabilité. L'approche S3 native renverse complètement ce modèle.
Lire l'article →
Réversibilité : comment récupérer ses données, embeddings et historiques en quittant un fournisseur d’IA
Dans un contexte où les modèles d’intelligence artificielle deviennent des socles stratégiques pour l’entreprise, la capacité à sortir d’un service cloud ou d’une API tierce sans perdre de précieuses ressources (datasets, vecteurs d’embedding, journaux d’inférence) se révèle cruciale. Au‑delà du simple droit de portabilité prévu par le RGPD, les organisations doivent mettre en place des processus
Lire l'article →La conformité NIS2, RGPD et SEC 17a-4 commence par la maîtrise documentaire
Les audits modernes échouent rarement parce que les entreprises ne travaillent pas. Ils échouent parce que les preuves sont introuvables : documents dispersés, versions contradictoires, historique absent, responsabilités floues.
Lire l'article →Ransomware : pourquoi la restauration est devenue plus importante que la protection
Aucune organisation n'est totalement protégée. La question n'est plus « serons-nous attaqués ? » mais « combien de temps nous faudra-t-il pour revenir à un état sain ? ». La résilience devient l'indicateur clé de la cybersécurité.
Lire l'article →
Forensic IA : quelles traces préserver pour comprendre un incident impliquant un modèle ?
L’essor de l’intelligence artificielle (IA) dans les systèmes d’information transforme la façon dont les organisations prennent des décisions, mais introduit également une nouvelle catégorie d’incidents : ceux qui concernent directement les modèles. Analyser ces dysfonctionnements nécessite une approche forensique adaptée, capable de capturer et de conserver des artefacts très différents de ceux h
Lire l'article →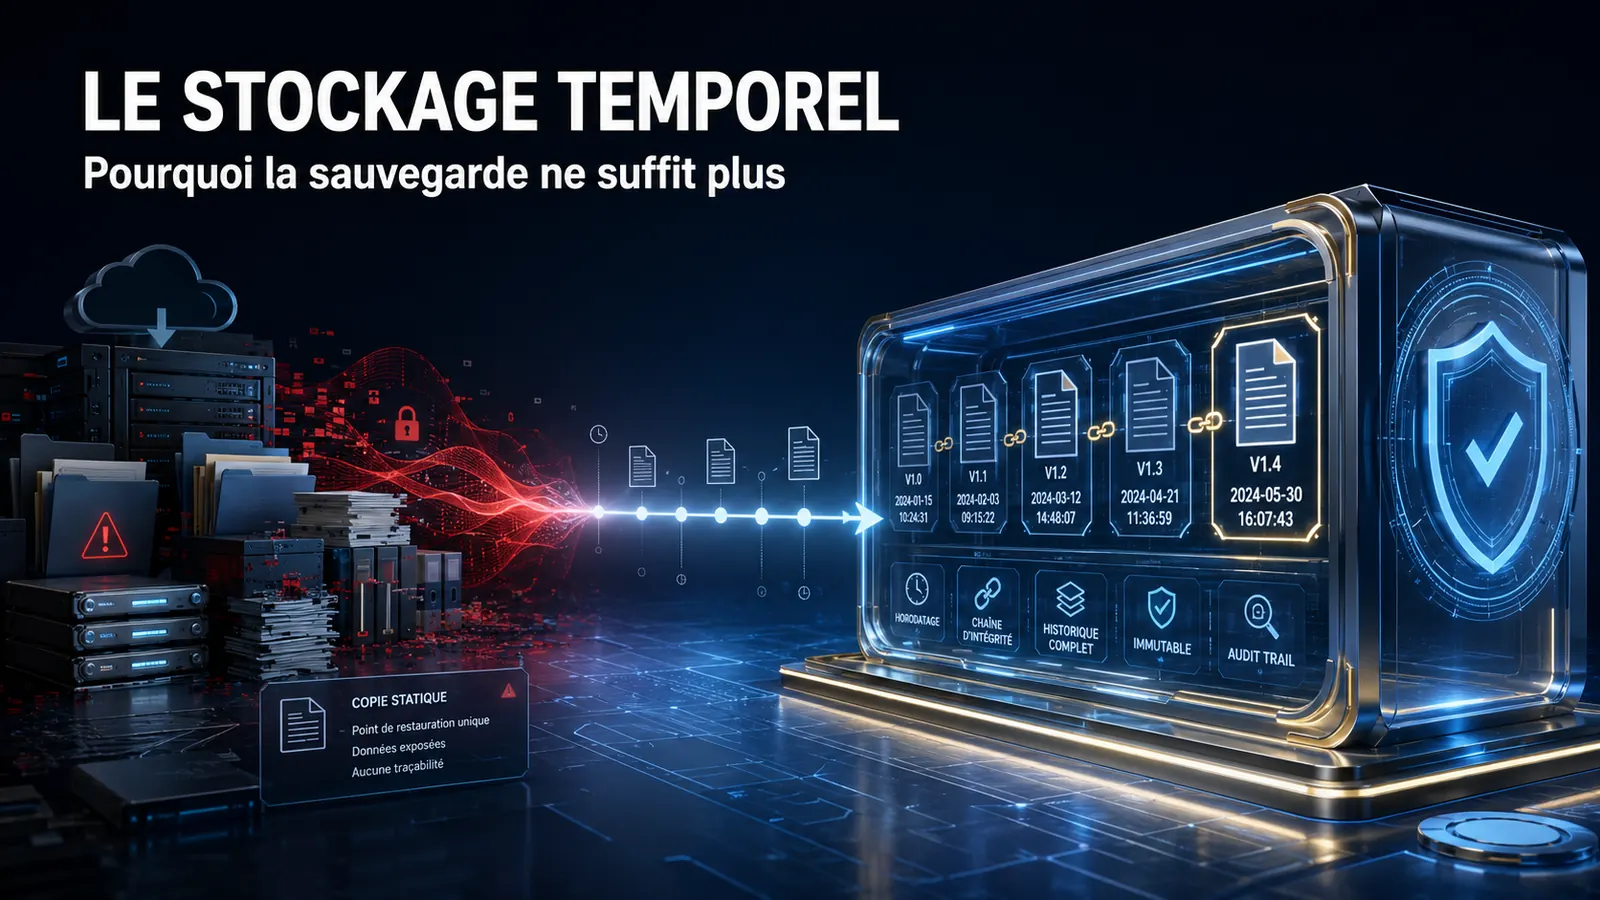
Le stockage temporel : pourquoi la sauvegarde ne suffit plus
Depuis vingt ans, les entreprises protègent leurs données par des sauvegardes. Cette approche répondait à la perte accidentelle. Elle ne répond plus aux cyberattaques, aux ransomwares, à la corruption silencieuse ni aux exigences modernes d'audit.
Lire l'article →
Quantum‑Ready Key Management : préparer les infrastructures PKI aux ordinateurs quantiques d’ici 2026
Chapô – Les algorithmes de chiffrement à courbes elliptiques et RSA, piliers des chaînes de confiance numériques depuis trois décennies, sont menacés par l’émergence éventuelle d’ordinateurs quantiques capables d’exécuter l’algorithme de Shor. Face à ce risque latent mais crédible, les organisations doivent dès aujourd’hui rendre leurs systèmes de gestion de clés (Key Management Systems – KMS) « q
Lire l'article →
Journaliser les interactions avec l’IA sans créer une nouvelle base de données personnelles
Les systèmes d’intelligence artificielle (IA) collectent chaque jour des millions d’échanges texte, vocal ou visuel. Pour garantir la traçabilité, détecter les dérives et satisfaire les exigences réglementaires, les organisations doivent consigner ces interactions. Pourtant, un enregistrement naïf aboutit rapidement à la constitution d’une base de données contenant des informations personnelles (P
Lire l'article →
Observabilité Zero‑Trust : comment le tracing distribué s’allie à des contrôles d’accès dynamiques en 2025
Chapô – En 2025, la convergence du modèle de sécurité Zero‑Trust et des pratiques d’observabilité transforme la façon dont les organisations surveillent leurs systèmes distribués. Le tracing, pilier du monitoring cloud‑native, ne suffit plus : il doit être enrichi de politiques d’accès contextuelles, automatisées et vérifiables. Cet article décrypte les concepts, l’architecture et les enjeux opéra
Lire l'article →
Déploiement continu de modèles IA via GitOps : pipelines automatisés, validation de conformité et roll‑back instantané
Le déploiement des modèles d’intelligence artificielle (IA) passe aujourd’hui du lotissement ponctuel à une pratique continue comparable aux livraisons logicielles classiques. En combinant les principes de GitOps avec les méthodologies MLOps, les organisations peuvent automatiser la construction, le test et la mise en production des modèles tout en garantissant traçabilité, conformité réglementair
Lire l'article →
Vidéosurveillance, drones et IoT : garantir la valeur probatoire des données captées
Chapô – La multiplication des caméras de surveillance, des drones autonomes et des capteurs IoT transforme les territoires en réseaux d’observation permanents. Au-delà du seul aspect sécuritaire, ces flux vidéo sont de plus en plus exploités comme preuves dans des procédures civiles ou pénales. Mais la valeur probatoire d’une image n’est pas acquise : elle dépend de la chaîne de confiance qui la l
Lire l'article →
Le futur du stockage : versionnage, temporalité et immutabilité au service de la conformité
La transformation numérique fait exploser les volumes de données sensibles. Avec NIS2, prouver ses actions dépend autant du comment on conserve que du quoi on conserve. Versionnage, gestion fine de la temporalité et immutabilité deviennent les piliers d'une stratégie de stockage conforme.
Lire l'article →
Prompt injection : quand un document interne devient une instruction malveillante pour l’IA
Les modèles de langage génératif (LLM) sont aujourd’hui intégrés aux systèmes d’information pour automatiser le support, enrichir les bases de connaissances ou piloter des processus métier. Cette dépendance crée un nouveau vecteur d’attaque : la prompt injection. Un simple fichier texte, une note interne ou même un ticket de suivi peut être transformé en instruction qui détourne l’IA, modifie son
Lire l'article →
IA souveraine : pourquoi les données d'entraînement doivent rester sous contrôle
L'intelligence artificielle s'alimente de jeux massifs de données. Dans le cadre de NIS2, la souveraineté des datasets d'entraînement devient un critère clé de conformité : chaque décision algorithmique doit reposer sur une information traçable, intègre et non altérée.
Lire l'article →
Edge AI Governance : comment auditer et contrôler les modèles déployés sur des appareils IoT ultra‑légers
Chapô – 108 mots Les dispositifs IoT ultra‑légers (capteurs, actionneurs ou micro‑contrôleurs à quelques dizaines de kilooctets de RAM) voient leurs capacités d’inférence IA se multiplier grâce aux techniques de quantification, pruning et TinyML. Cette évolution ouvre des perspectives inédites – détection d’anomalies en temps réel, optimisation énergétique locale – mais introduit également une cha
Lire l'article →
Fusion‑acquisition : comment empêcher une IA de mélanger les patrimoines informationnels de deux entreprises ?
La multiplication des opérations de fusion‑acquisition (M&A) dans le secteur du numérique entraîne un défi inédit : protéger la souveraineté des données lorsqu’une intelligence artificielle (IA) est mobilisée pour analyser, classer ou migrer les actifs informationnels. Un mélange involontaire de bases de connaissances, de modèles et de métadonnées peut compromettre la confidentialité, la conformit
Lire l'article →La piste d'audit comme source de vérité économique
Dès lors que chaque opération de stockage est tracée, la piste d'audit change de nature : elle cesse d'être un simple journal de sécurité pour devenir une source de vérité économique. Cet article explore comment connecter identité, opération et consommation de ressources pour piloter les coûts avec précision.
Lire l'article →
Fine‑tuning : que devient le savoir de l’entreprise lorsqu’il entre dans les paramètres d’un modèle ?
Le fine‑tuning, technique qui consiste à adapter un grand modèle de langue (LLM) ou un modèle visionnaire aux spécificités d’une organisation, soulève des questions fondamentales : où se loge le patrimoine cognitif de l’entreprise ? Qui en possède les droits ? Quels risques de fuite ou de biais introduit‑il ? Cet article décortique le processus technique, les enjeux de gouvernance et de conformité
Lire l'article →
Contrats, licences et droits d’usage : les données internes peuvent‑elles réellement servir à entraîner une IA ?
Les organisations s’empressent de nourrir leurs modèles d’intelligence artificielle avec leurs propres jeux de données : logs serveur, historiques clients, rapports de maintenance ou encore courriels internes. Mais la simple détention de ces informations ne suffit pas à les exploiter librement. Entre le droit d’auteur, les clauses contractuelles, les exigences du RGPD et les nouvelles obligations
Lire l'article →
Data lineage : comment suivre une information depuis le document d’origine jusqu’à la réponse de l’IA ?
Dans un contexte où les modèles d’intelligence artificielle (IA) sont sollicités pour extraire, enrichir ou synthétiser des connaissances à partir de volumes croissants de documents, la traçabilité du parcours des données devient une exigence opérationnelle et réglementaire majeure. Le data lineage (ou traçabilité des données) permet d’établir, à chaque étape – ingestion, transformation, stockage,
Lire l'article →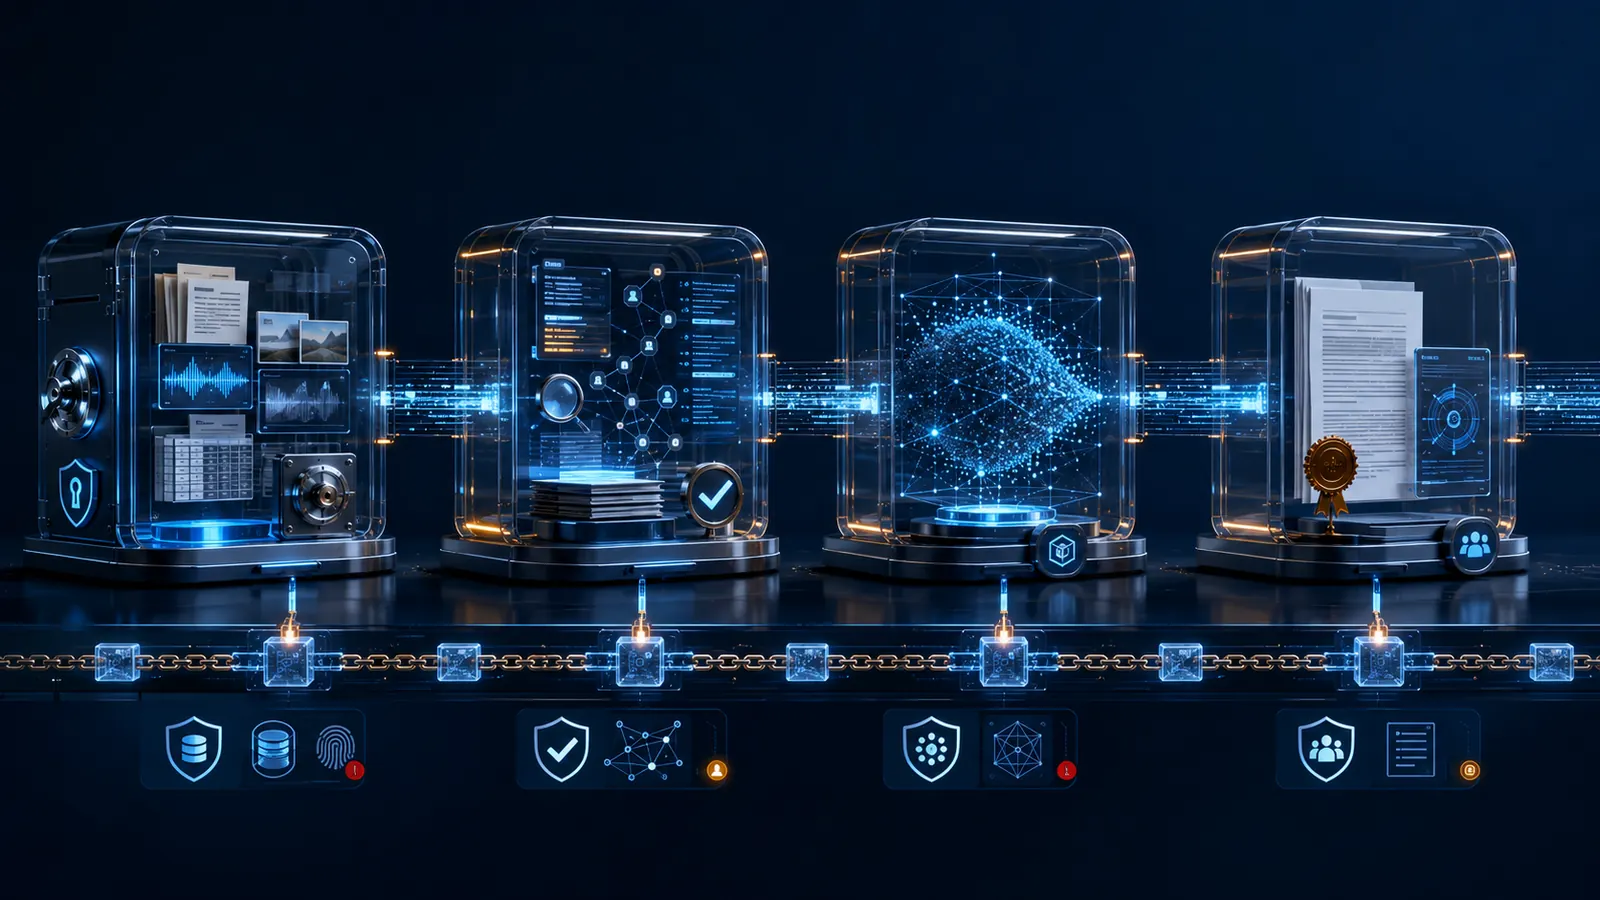
Donnée source, donnée enrichie, embedding ou réponse générée : que faut‑il réellement protéger ?
Dans les architectures d’intelligence artificielle générative, la donnée circule sous plusieurs formes : la donnée brute (source), les dérivés enrichis, les vecteurs d’embedding et enfin les réponses synthétisées. Chacune de ces « actifs de données » possède un profil de risque distinct, tant sur le plan de la confidentialité que de l’intégrité ou de la propriété intellectuelle. Cet article décort
Lire l'article →
Données synthétiques : solution de confidentialité ou nouvelle source de risques invisibles ?
Face à l’exigence croissante de protection des données personnelles (RGPD, CCPA) et à la demande d’enrichissement des jeux de données pour l’intelligence artificielle, les organisations se tournent vers les données synthétiques. Ces ensembles factices, générés par des modèles statistiques ou d’apprentissage profond, visent à préserver la confidentialité tout en conservant la valeur analytique des
Lire l'article →
Identités machines : qui est responsable lorsqu’un agent IA agit avec des privilèges administrateur ?
L’émergence d’agents intelligents capables d’exécuter des tâches automatisées à l’échelle du système pousse les organisations à leur octroyer des identités machine dotées de droits élevés, voire d’accès administrateur. Cette évolution soulève une question cruciale : qui porte la responsabilité juridique, opérationnelle et sécuritaire lorsqu’un tel agent cause un dommage ou commet une faute ? Dans
Lire l'article →Implémenter l’internationalisation (i18n) dans les produits web Rust
Guide complet pour architectes, développeurs et décideurs
Lire l'article →
Prompts et réponses générées : simples données temporaires ou nouvelles archives de l’entreprise ?
L’essor des modèles de langage (LLM) transforme la manière dont les organisations interagissent avec leurs systèmes d’information. Chaque requête (« prompt ») et chaque réponse produite par une IA peuvent contenir des informations sensibles, des décisions opérationnelles ou des connaissances métier. Face à cette évolution, les DSI, RSSI et responsables de la gouvernance des données se demandent s’
Lire l'article →
Modèle décommissionné : quelles données conserver pour répondre à un audit plusieurs années plus tard ?
Lorsqu’une application ou une infrastructure atteint la fin de son cycle de vie, les équipes informatiques procèdent souvent à son retrait définitif – le décommissionnement. Au‑delà du simple arrêt des services, cette opération soulève une question cruciale : quelles données doivent être archivées afin de pouvoir justifier, plusieurs années plus tard, la conformité aux exigences légales, réglement
Lire l'article →
Contrôle d’accès et intelligence artificielle : l’IA doit‑elle pouvoir lire tout ce que son utilisateur peut consulter ?
La montée en puissance des IA génératives pousse les organisations à repenser leurs modèles de contrôle d’accès. Un assistant virtuel qui pourrait, à la demande d’un collaborateur, explorer l’ensemble des ressources auxquelles celui‑ci a droit soulève autant d’opportunités que de risques : gains de productivité, mais aussi fuites de données, biais de conformité et nouveaux vecteurs d’attaque. Cet
Lire l'article →
Dérive des données : comment savoir quand le référentiel d’une IA ne représente plus la réalité ?
Les modèles d’intelligence artificielle s’appuient sur un jeu de données historique qui sert de référence (« référentiel ») pour leurs prédictions. Au fil du temps, ce référentiel peut s’écarter de la réalité opérationnelle : les distributions changent, les comportements évoluent, les biais se renforcent. Cette « dérive des données » (ou data drift) menace la fiabilité, la conformité et la valeur
Lire l'article →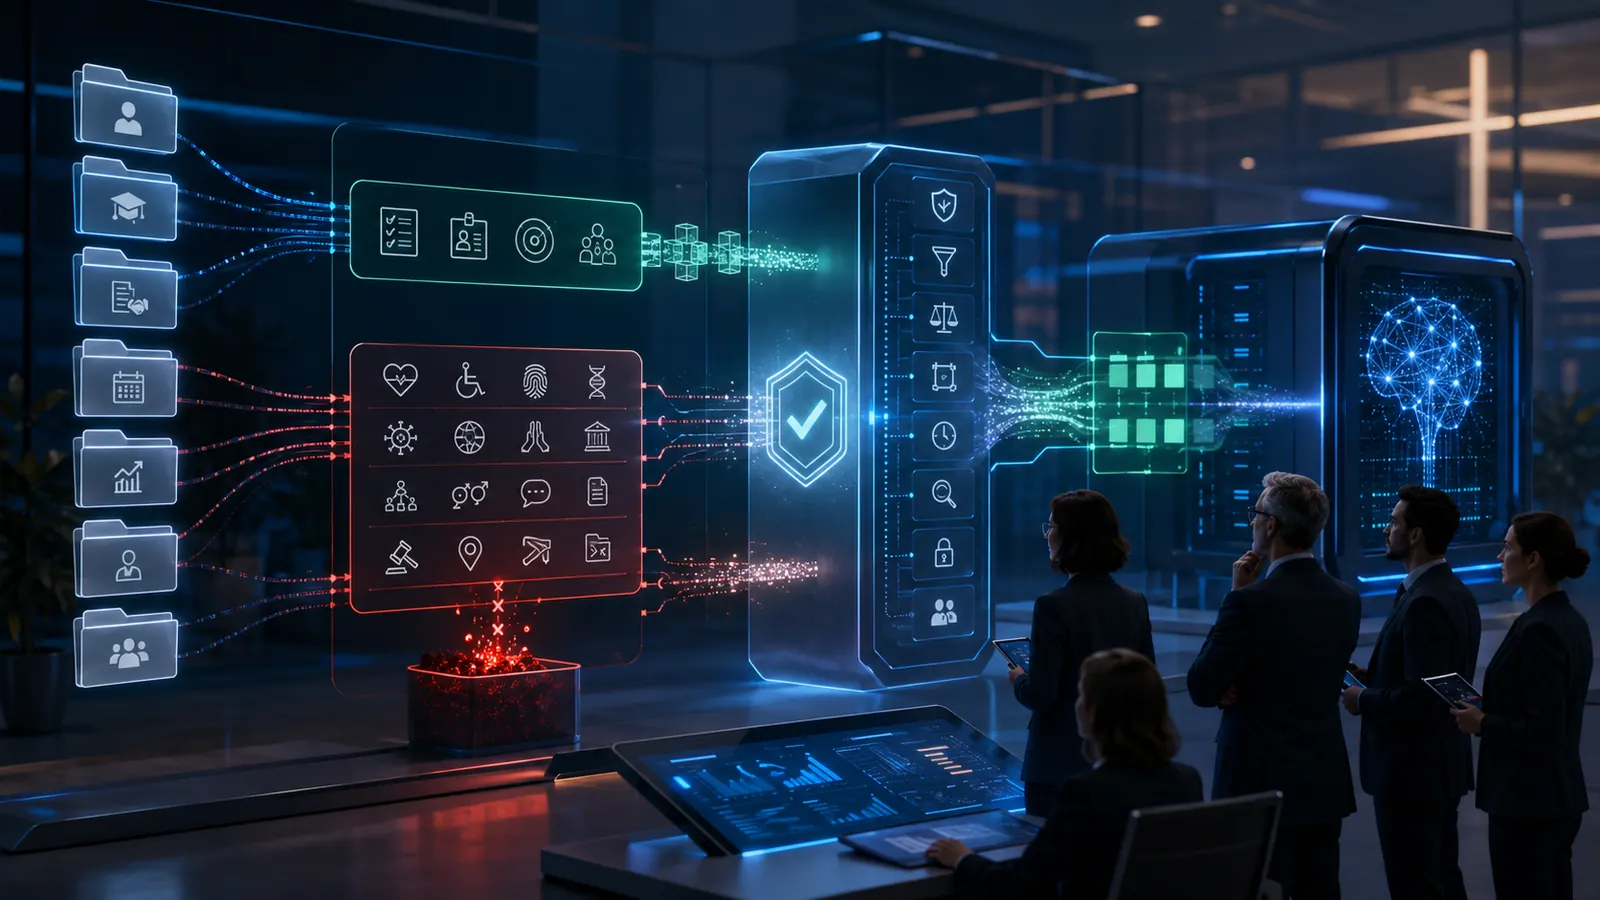
Ressources humaines : quelles données ne devraient jamais alimenter un système d’IA interne ?
Les organisations investissent massivement dans l’intelligence artificielle pour optimiser le recrutement, la gestion des talents ou la planification de la main‑d’œuvre. Pourtant, toutes les informations détenues par les services RH ne sont pas compatibles avec ces usages. Entre exigences du RGPD, risques de discrimination et vecteurs d’attaques : quelles catégories de données doivent être exclues
Lire l'article →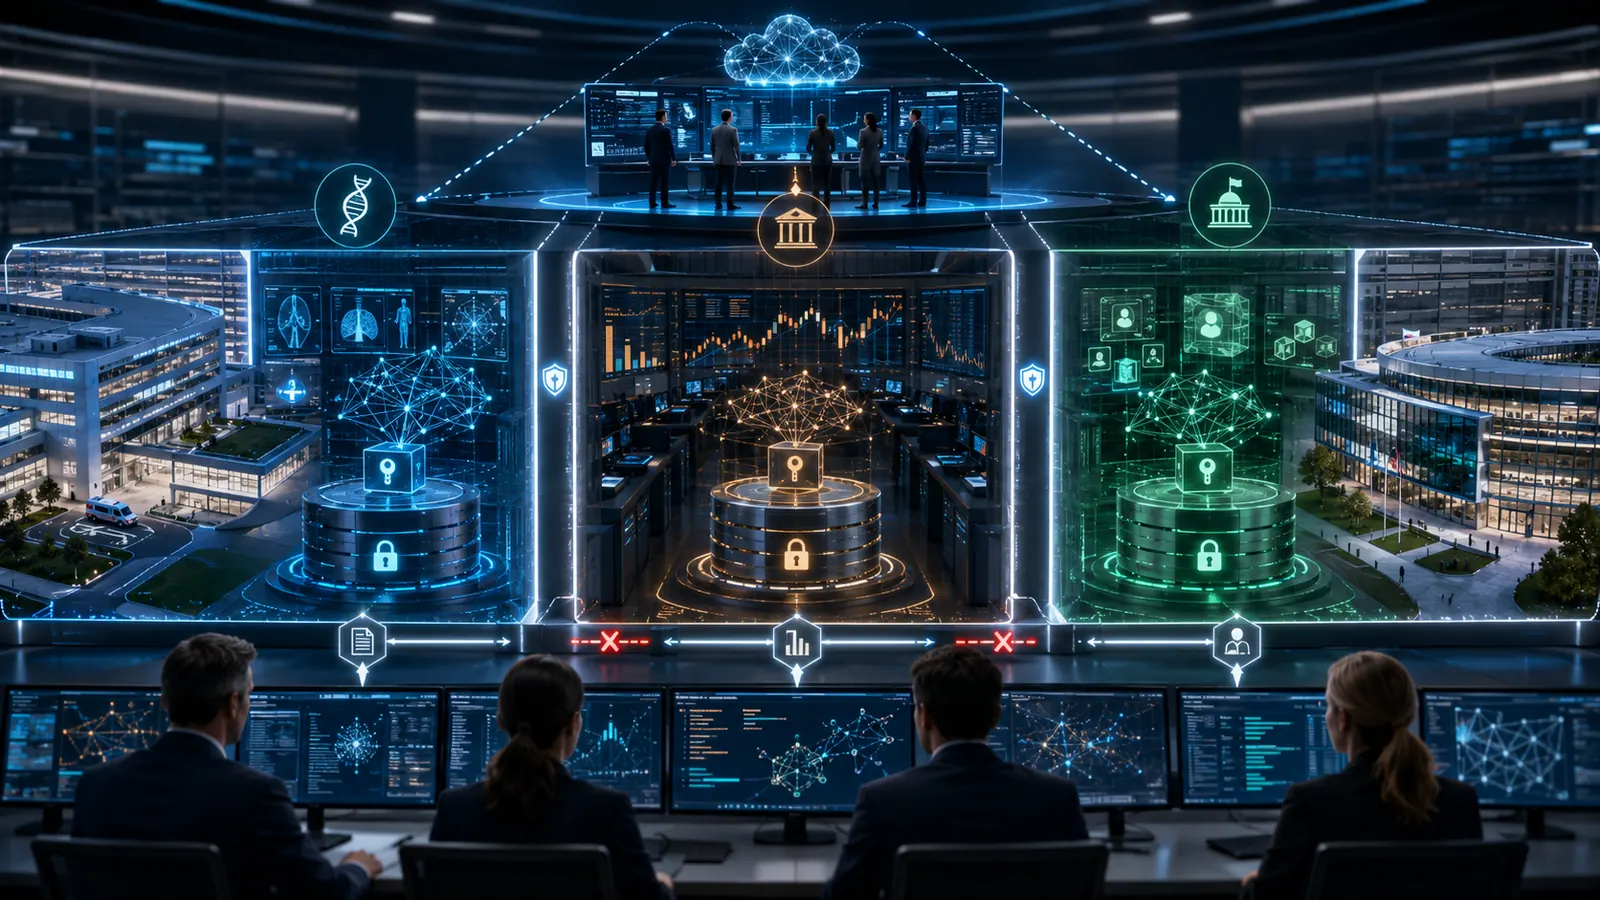
Santé, finance et secteur public : pourquoi toutes les données d’IA ne peuvent pas partager la même infrastructure
Les modèles d’intelligence artificielle promettent des gains de productivité dans la santé, la finance et l’administration publique. Pourtant, les exigences de confidentialité, de conformité réglementaire et de résilience opérationnelle divergent fortement entre ces secteurs. Partager une infrastructure unique – que ce soit un cloud public, un datacenter interne ou une plateforme d’entraînement –
Lire l'article →
Départs de collaborateurs : comment retirer leurs accès sans perdre la traçabilité de leurs contributions ?
Dans un contexte où les menaces internes et les exigences de conformité s’intensifient, le processus d’off‑boarding devient un levier stratégique. Révoquer rapidement les droits d’accès tout en conservant une piste d’audit fiable des actions passées nécessite la convergence de bonnes pratiques organisationnelles, d’outils d’IAM (Identity & Access Management) et de solutions d’observabilité. Cet ar
Lire l'article →Kubernetes et cloud‑native : comment protéger les états critiques d’une infrastructure éphémère
Chapô – Dans les architectures cloud‑native, l’évolutivité et la résilience reposent sur l’éphémérité des composants : pods qui naissent, se déplacent ou meurent en quelques secondes. Cette dynamique contredit le besoin de persistance pour les bases de données, les files d’attente ou tout autre état critique. Entre exigences de sécurité (confidentialité, intégrité, disponibilité), contraintes régl
Lire l'article →Migration d’auditeurs legacy C vers Rust : étude de cas concrète
Chapô – Les outils d’audit de conformité et de sécurité, longtemps écrits en C pour leurs performances proches du matériel, peinent aujourd’hui à répondre aux exigences de sûreté mémoire imposées par les normes modernes. Cette tension entre héritage fonctionnel et risques de vulnérabilités pousse plusieurs organisations à envisager une réécriture en Rust, langage réputé « memory‑safe ». À travers
Lire l'article →Formats de journalisation orientés conformité (JSON, Syslog) pour les pistes d’audit
Dans un contexte où la réglementation impose une traçabilité exhaustive des activités informatiques – GDPR, PCI DSS, NIS2 ou encore SOX – les formats de logs deviennent un levier stratégique. JSON et Syslog, deux standards largement adoptés, offrent des mécanismes complémentaires pour garantir l’intégrité, la lisibilité et la pérennité des pistes d’audit. Cet article décortique leurs principes, co
Lire l'article →Tester le code asynchrone en Rust : des tests unitaires au testing basé sur les propriétés
Chapô – Le langage Rust séduit par sa sûreté mémoire et ses performances, mais son modèle d’asynchronisme introduit des bugs difficiles à détecter. Entre la gestion du runtime (Tokio, async‑std), les futures qui se composent dynamiquement et les exigences de résilience logicielle, les équipes doivent repenser leurs stratégies de test. Cet article analyse les pratiques suivantes : tests unitaires c
Lire l'article →Handling Large Binary Assets with Streaming Responses in Axum
Dans un contexte où les applications web doivent servir des fichiers de plusieurs gigaoctets – vidéos, archives, images médicales ou bases de données exportées – la capacité à diffuser ces actifs sans saturer la mémoire serveur devient cruciale. Le framework Rust Axum, construit sur Tokio et Hyper, propose une approche native du streaming HTTP qui répond aux exigences de scalabilité, de résilience
Lire l'article →Managing Configuration Drift Across Multi‑Region Deployments
Chapô – Dans un environnement cloud où les services sont répliqués sur plusieurs régions géographiques pour garantir la disponibilité, la latence minimale et la conformité locale, le configuration drift (écart de configuration) devient l’un des principaux facteurs d’instabilité. Quand les ressources d’infrastructure‑as‑code (IaC) ne reflètent plus l’état réel du système, les équipes font face à de
Lire l'article →Concevoir des APIs idempotentes pour les services d’audit
Un guide complet pour garantir la fiabilité, la traçabilité et la conformité des opérations d’audit dans un environnement micro‑services.
Lire l'article →Pourquoi Rust devient le langage de prédilection pour le Confidential Computing
Chapô – 100 mots Le Confidential Computing (CC) protège les données et le code pendant leur exécution via des enclaves matérielles comme Intel SGX, AMD SEV ou les Trusted Execution Environments (TEE) de Microsoft Azure. Le choix du langage de programmation impacte la sécurité, la performance et la maintenabilité des solutions. Rust, grâce à son modèle de sécurité mémoire sans ramasse‑miettes, ses
Lire l'article →Benchmarking des algorithmes de hachage de fichiers en Rust : performances, enjeux et bonnes pratiques
Chapô – Avec l'explosion des volumes de données, la vérification d’intégrité devient une contrainte opérationnelle majeure pour les sauvegardes, le CI/CD et la conformité. Le choix d’un algorithme de hachage performant est alors déterminant. Le langage Rust, reconnu pour sa sûreté mémoire et son efficacité native, propose un écosystème riche en bibliothèques : ring, sha2, blake3, etc. Cet article
Lire l'article →Appliquer le Domain‑Driven Design (DDD) en Rust pour une logique métier complexe
Chapô – La compétitivité reposant désormais sur des processus métiers sophistiqués, les équipes techniques recherchent des langages alliant sécurité, performance et expressivité. Le Domain‑Driven Design (DDD), méthode reconnue pour structurer la logique métier, rencontre le langage Rust, reconnu pour son modèle de possession et ses garanties d’absence de data races. Cet article analyse l'articulat
Lire l'article →Implémenter un protocole de transfert sécurisé avec tokio‑rustls : enjeux, architecture et bonnes pratiques
Par [Nom du journaliste], analyste senior en systèmes d’information
Lire l'article →Audits de sécurité des crates tierces : comment sélectionner et valider les dépendances
Chapô – Dans un écosystème où le code source s’enrichit chaque jour d’une multitude de bibliothèques open‑source, les projets Rust ne font pas exception. Les « crates » partagées sur crates.io offrent des gains de productivité considérables, mais introduisent également une surface d’attaque difficile à maîtriser. Entre vulnérabilités connues (CVE), pratiques de dé
Lire l'article →Auditer en mode événementiel avec Amazon SNS/SQS et des consommateurs Rust : principes, mise en œuvre et enjeux
Chapô – La traçabilité des actions étant devenue une exigence réglementaire et opérationnelle majeure, l’audit « event‑driven » s'est imposé comme une alternative aux logs traditionnels. En combinant les services de messagerie asynchrones d’AWS (SNS + SQS) avec des micro‑services écrits en Rust, les organisations peuvent construir
Lire l'article →Containeriser des micro‑services Rust : du Dockerfile à la production
Chapô – Le langage Rust séduit les équipes souhaitant allier performance native, sûreté mémoire et faible empreinte CPU. Les architectures « micro‑service » étant le socle des applications cloud‑native, la mise en conteneur est devenue incontournable. Ce guide détaille le passage d’un simple Dockerfile à une chaîne de production : optimisation du build, pratiques
Lire l'article →Contrôle d’accès basé sur les politiques (PBAC) dans les systèmes de fichiers distribués
Les systèmes de fichiers distribués (DFS) sont le socle du stockage massif utilisé par les clouds, les data‑lakes et les environnements hybrides. Alors que la volumétrie et la diversité des acteurs augmentent, les modèles classiques de contrôle d’accès (RBAC) montrent leurs limites : ils peinent à exprimer des exigences de conformité complexes, à gérer des contextes dynamiques ou à assurer une tra
Lire l'article →Concevoir des architectures à plug‑in pour les applications cloud‑native
Comment bâtir des systèmes extensibles, sécurisés et résilients dans un environnement Kubernetes‑first.
Lire l'article →Utiliser efficacement les feature flags pour désactiver des dépendances lourdes (ex. ONNX)
Chapô – Les feature flags (ou commutateurs fonctionnels) sont un pilier du DevOps moderne pour livrer du code en continu tout en maîtrisant le risque fonctionnel. Lorsqu’une fonctionnalité repose sur une bibliothèque ou un composant lourd – comme les modèles d’inférence ONNX, les moteurs de rendu GPU ou les bibliothèques de traitement vidéo – la capacité à activer ou désactiver dynamiquement cette
Lire l'article →Intégrer des back‑ends Rust aux front‑ends JavaScript via WebAssembly
Depuis l’émergence de WebAssembly (Wasm) en 2017, les développeurs peuvent exécuter du code natif dans le navigateur avec une performance proche du métal. Le langage Rust, réputé pour sa sûreté mémoire et son efficacité, devient un candidat privilégié pour écrire des parties critiques d’une application côté client ou serveur et les compiler en Wasm. Cette combinaison ouvre la voie à des architectu
Lire l'article →Services de conversion de documents à grande échelle avec Tokio et Hyper
Chapô – 96 mots La conversion massive de fichiers (PDF, Office, images scannées…) est un pilier des processus d’automatisation documentaire : facturation électronique, archivage juridique, IA générative ou ingestion de données. Les solutions monolithiques basées sur des appels bloquants peinent à répondre aux exigences de débit, de latence et de résilience imposées par les environ
Lire l'article →Construire des outils en ligne de commande résilients avec clap et les sous‑commandes asynchrones
Les interfaces en ligne de commande (CLI) restent le pilier des workflows d’ingénierie, du DevOps aux opérations cloud. Pourtant, la montée en complexité – appels réseau, traitements parallèles, interaction avec des API tierces – expose rapidement les outils classiques à des blocages, des fuites de ressources ou des comportements imprévisibles. En s’appuyant sur le crate clap (Command Line Argumen
Lire l'article →AI‑Assisted Image Processing avec ONNX Runtime en Rust
L’inférence de modèles d’intelligence artificielle (IA) sur des images est aujourd’hui un pilier des applications métiers – détection d’anomalies, amélioration de la qualité visuelle, reconnaissance d’objets ou segmentation médicale. Le recours à ONNX Runtime, moteur d’exécution open‑source compatible avec le format interopérable ONNX, combiné au langage système Rust promet une performance native,
Lire l'article →Data‑Lake Ingestion Pipelines in Rust – De CSV à Parquet via calamine et zip
Chapô (96 mots)<0xC2><0xA0>: Face à l'explosion des volumes de données brutes, la construction d’un data‑lake fiable repose sur des pipelines d’ingestion performants. Le langage Rust, reconnu pour sa sûreté mémoire et ses performances proches du C, attire les équipes DevSecOps cherchant à allier vitesse d’exécution, faible empreinte CPU et absence de fuites ou de débordements. Cet
Lire l'article →Tracer pour mieux observer : le tracing au service de l’observabilité des applications Rust distribuées
Chapô – Avec la multiplication des architectures micro‑services et des fonctions serverless, la visibilité sur le comportement d’une application est fondamentale. Le langage Rust, reconnu pour ses performances et sa sûreté mémoire, s'impose comme socle de services critiques. Exploiter ces atouts nécessite une stratégie d’observabilité adaptée : le tracing permet de collecter, corr
Lire l'article →Zero‑Copy : optimiser le transfert de données entre interfaces web et workers back‑end en Rust
Chapô – Dans les architectures modernes où les interfaces utilisateur (UI) s’exécutent dans le navigateur ou via WebAssembly, la latence et la consommation mémoire liées aux copies de données peuvent devenir un goulet d’étranglement. Le langage Rust, grâce à son modèle de possession et à ses bibliothèques orientées performance (Tokio, bytes, wasm‑bindgen), offre d
Lire l'article →Design Patterns pour des Front‑ends Modulaires avec Axum et Tokio
Dans un contexte où les interfaces utilisateur deviennent de plus en plus complexes, la modularité est devenue une exigence clé pour garantir évolutivité, maintenabilité et résilience. Le langage Rust, grâce à son modèle de sécurité mémoire et à ses performances natives, séduit les équipes qui souhaitent développer des front‑ends modernes via WebAssembly ou servir des micro‑front‑ends depuis le se
Lire l'article →Aucun article ne correspond à cette recherche.